Inicio
» Tecnología
»
¿Se ha visto afectado Salesforce por la reciente interrupción del servicio de AWS? Qué comprobar antes de culpar a la nube.
¿Se ha visto afectado Salesforce por la reciente interrupción del servicio de AWS? Qué comprobar antes de culpar a la nube.
Si Salesforce funciona lento, falla un inicio de sesión o una integración deja de funcionar repentinamente justo cuando se anuncia una interrupción del servicio de AWS, es tentador relacionar ambos problemas de inmediato. En algunos casos, este diagnóstico puede ser correcto, pero no siempre.
Al 16 de septiembre de 2026, no existe evidencia pública de que una interrupción generalizada de Salesforce se deba a la reciente interrupción de AWS. AWS continúa reportando una interrupción importante y prolongada del servicio en su región de Oriente Medio (Baréin) y graves problemas en algunas zonas de su región de Oriente Medio (Emiratos Árabes Unidos). Salesforce ejecuta cargas de trabajo de Hyperforce en AWS en varios países, incluidos los Emiratos Árabes Unidos, por lo que un problema regional de AWS podría afectar a algunos clientes de Salesforce. Sin embargo, es necesario verificar el estado de Salesforce a nivel de organización, instancia, región y servicio específicos antes de concluir que AWS es la causa.
Este artículo explica qué está confirmado, qué no, cómo saber si su entorno de Salesforce se ve afectado y cuándo debe dejar de esperar a que aparezca una página de estado pública e investigar su propia red, navegador, integración o inquilino.
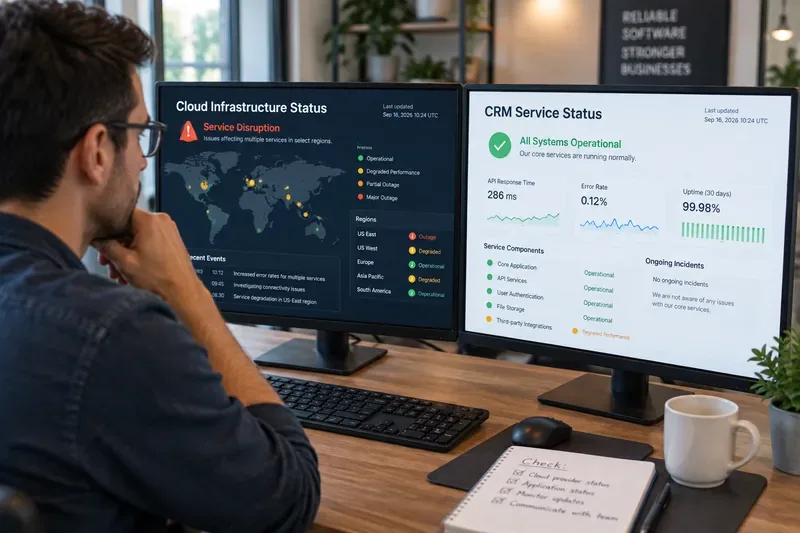
Un analista de operaciones compara el estado del proveedor de la nube con el estado de la aplicación; un incidente regional en la nube no significa automáticamente que todas las organizaciones de Salesforce se vean afectadas.
¿Cuál es la reciente interrupción del servicio de AWS?
La última gran interrupción que aún se puede apreciar en el historial de salud pública de AWS se concentra en Oriente Medio. AWS afirma que su región de Oriente Medio (Baréin), identificada como me-south-1 , no está disponible debido a daños físicos, mientras que su región de Oriente Medio (EAU), me-central-1 , también ha sufrido graves problemas.
AWS informó que las instalaciones afectadas sufrieron daños físicos durante el conflicto regional en marzo de 2026. El 30 de abril, AWS comunicó que la región de Bahréin seguía sin estar disponible y que la región de los Emiratos Árabes Unidos no podía brindar soporte confiable a las aplicaciones de los clientes. AWS recomendó a los clientes afectados que recuperaran sus cargas de trabajo en otras regiones y restauraran los recursos inaccesibles a partir de copias de seguridad remotas, siempre que fuera posible.
Puedes verificar el estado actual e histórico de los eventos directamente en el panel de control de AWS Health . AWS también explica que la vista pública de Service Health muestra eventos generales del servicio, mientras que los clientes que han iniciado sesión pueden ver problemas específicos de su cuenta en su vista personalizada de AWS Health.
¿Salesforce está caído debido a AWS?
No de forma generalizada, según la información pública disponible el 16 de septiembre de 2026.
El sitio web público de Salesforce Trust Status es el principal lugar para consultar los incidentes de Salesforce. En el momento de la revisión, Salesforce no había publicado ningún incidente que afectara a toda la plataforma y que atribuyera los problemas generalizados de disponibilidad de Salesforce a la interrupción del servicio de AWS en Oriente Medio.
Esa distinción es importante. Un proveedor de servicios en la nube puede sufrir una interrupción grave en una región sin que ello afecte a todas las empresas de software que lo utilizan a nivel global. Las plataformas SaaS modernas suelen operar en múltiples regiones, zonas de disponibilidad, capas de enrutamiento y entornos de infraestructura. Por lo tanto, la pregunta relevante no es simplemente "¿Está AWS experimentando una interrupción?", sino "¿Mi organización de Salesforce o algún servicio del que dependa se ejecuta en la ruta de infraestructura afectada?".
¿Por qué AWS podría ser relevante para Salesforce?
La arquitectura Hyperforce de Salesforce ejecuta muchas cargas de trabajo de Salesforce en infraestructura de nube pública. La documentación actual de Salesforce indica que Hyperforce está disponible en AWS en varios países, incluidos Australia, Brasil, Canadá, Francia, Alemania, India, Indonesia, Israel, Italia, Japón, Singapur, Sudáfrica, Corea del Sur, Suecia, Suiza, Emiratos Árabes Unidos, Reino Unido y Estados Unidos.
Salesforce también documenta que algunas instancias de Hyperforce están asignadas a regiones específicas de AWS. Por ejemplo, su documentación sobre la ubicación de las instancias enumera las regiones de AWS correspondientes a varias ubicaciones geográficas de Hyperforce. La compañía indica además que los clientes pueden identificar su instancia de Salesforce y usar Salesforce Trust para consultar su ubicación y estado.
El objetivo no es simplemente encontrar un icono de estado rojo o verde. Un diagnóstico útil debería responder a tres preguntas:
Alcance: ¿El problema afecta a todos, a una instancia de Salesforce, a un producto, a una integración o solo a su organización?
Causa: ¿Existe algún incidente oficial de Salesforce, un evento regional de AWS o evidencia de que el problema sea local a su navegador, red, configuración de autenticación o integración?
Siguiente acción: ¿Deben los usuarios esperar, realizar una conmutación por error, reintentar más tarde, cambiar de flujo de trabajo, ponerse en contacto con el soporte de Salesforce o investigar una dependencia interna?
Si aún no puede responder a esas tres preguntas, se trata de una observación del estado, no de un diagnóstico.
¿Cómo se puede comprobar si tu organización de Salesforce se ve afectada?
1. Identifique su instancia de Salesforce.
Salesforce recomienda verificar el campo Instancia en Configuración, dentro de Información de la empresa, o buscar su dominio en Salesforce Trust. La identidad de la instancia es importante porque el estado del servicio puede variar entre regiones y grupos de infraestructura.
Un buen resultado en esta etapa es sencillo: conoces el nombre de la instancia que está utilizando la organización de producción afectada. No realices el diagnóstico desde la organización de un compañero, un entorno de pruebas en otra región o un encabezado de estado genérico de Salesforce.
2. Busca esa instancia en Salesforce Trust.
Acceda a Salesforce Trust y busque su instancia o dominio. Consulte los incidentes actuales, el historial de incidentes recientes y el mantenimiento programado.
Si Salesforce indica que hay una interrupción activa en su instancia y los síntomas coinciden con lo que ven sus usuarios, eso constituye una prueba mucho más sólida que una publicación en redes sociales o un titular general sobre una interrupción del servicio en la nube.
Si Salesforce Trust muestra que su instancia está en buen estado, no se detenga ahí. Las páginas de estado pueden tardar en actualizarse con respecto a los primeros informes de los clientes, y un problema puede afectar solo a una función, una dependencia o un grupo reducido de inquilinos.
3. Compare la fecha con el evento oficial de AWS.
Si tu organización de Salesforce utiliza Hyperforce con respaldo de AWS, compara el período de incidencias de Salesforce con el período de eventos de la región de AWS correspondiente. Para establecer una correlación significativa, es necesario que ambos eventos ocurran en más de un mes.
Por ejemplo, si su entorno de Salesforce está alojado en una región europea de AWS, una interrupción aislada en Bahréin no explica por sí sola el fallo. Si su carga de trabajo o un servicio dependiente se encuentra en la región de los Emiratos Árabes Unidos, la relación resulta más plausible y requiere una verificación más exhaustiva.
4. Prueba qué sigue funcionando.
Una solución de problemas de alta calidad permite identificar el problema en lugar de actualizar repetidamente la misma página. Pruebe algunas rutas representativas:
¿Pueden los usuarios iniciar sesión?
¿Pueden abrir los registros?
¿Pueden guardar las actualizaciones?
¿Las solicitudes a la API se realizan correctamente?
¿Están fallando las integraciones salientes o entrantes?
¿El problema se presenta en todos los navegadores y redes?
¿El problema se limita a una zona geográfica o a una oficina en particular?
El patrón importa. Un fallo total de inicio de sesión sugiere un dominio de fallo distinto al de una única integración retrasada. Si la interfaz de usuario de Salesforce funciona correctamente, pero falla un flujo de middleware hacia un sistema alojado en AWS, el impacto real podría estar en una etapa posterior de Salesforce, en lugar de en Salesforce mismo.
¿Puede Salesforce funcionar correctamente aunque una integración siga fallando?
Sí. Esta es una de las distinciones más importantes durante una interrupción del servicio en la nube.
Tu organización de Salesforce puede estar totalmente disponible mientras que un componente alojado en AWS con el que interactúa presenta un rendimiento degradado. Algunos ejemplos son el middleware, las API personalizadas, las canalizaciones de datos, los servicios de archivos, los componentes de identidad, los trabajos de análisis o las aplicaciones externas que se ejecutan en AWS.
En esa situación, Salesforce Trust puede mostrar correctamente que la plataforma Salesforce funciona correctamente, aunque un proceso empresarial dentro de su organización esté fallando.
Una prueba útil consiste en separar el comportamiento principal de Salesforce del comportamiento de las dependencias externas . Si los usuarios pueden crear y editar registros, pero la llamada a un servicio externo agota el tiempo de espera, conviene investigar la dependencia externa y su región. Si incluso la navegación básica de Salesforce falla en varios usuarios y redes, el estado de la instancia de Salesforce cobra mayor importancia.
¿Qué hay de los problemas con Salesforce que se reportaron a principios de septiembre?
Salesforce publicó varios incidentes a principios de septiembre de 2026, pero los registros públicos de incidentes no demuestran que fueran causados por la actual interrupción del servicio de AWS en Oriente Medio.
Por ejemplo, Salesforce registró una interrupción del servicio el 5 de septiembre que afectó a un grupo de plataformas "AWS US", la cual duró aproximadamente 90 minutos y se resolvió posteriormente. Por otra parte, Salesforce informó de un problema con Revenue Cloud que comenzó el 6 de septiembre y afirmó que su investigación indicaba que una actualización reciente era la causa. Salesforce también publicó un aviso informativo sobre el bloqueo intermitente de la interfaz de usuario en Chrome y Edge 153, y lo describió como un problema del navegador de terceros, en lugar de un problema de la infraestructura de Salesforce.
La lección es importante: varias interrupciones pueden ocurrir en momentos cercanos por razones completamente diferentes. Evite agrupar todos los problemas de Salesforce bajo la etiqueta "Interrupción de AWS" a menos que el proveedor los haya vinculado explícitamente.
¿Qué indicios sugieren que AWS podría estar realmente involucrada?
La evidencia se vuelve más sólida cuando coinciden varias señales:
Señal
Lo que te dice
Tu instancia de Salesforce está en Hyperforce usando AWS.
Existe una dependencia de AWS, pero esto por sí solo no demuestra el impacto.
La instancia o el servicio dependiente se asigna a la región de AWS afectada.
La interrupción regional es técnicamente relevante.
Salesforce Trust informa de un incidente para su instancia al mismo tiempo.
Existen pruebas directas del impacto por parte de Salesforce.
AWS Health informa de una degradación en la misma región y ventana de tiempo.
El incidente relacionado con la infraestructura coincide con el síntoma.
Usuarios en múltiples ubicaciones experimentan el mismo fallo.
Es menos probable que se trate de un problema puramente local de la oficina o del proveedor de servicios de Internet.
Solo falla una integración externa mientras que el núcleo de Salesforce permanece en buen estado.
La dependencia, y no el núcleo de Salesforce, podría ser el verdadero punto de fallo.
¿Cuándo deberías dejar de esperar a que aparezcan las páginas de estado?
Cambia tu método de resolución de problemas cuando la información pública ya no coincida con lo que ves.
Si Salesforce Trust está en verde, pero un grupo grande de usuarios no puede acceder a la misma instancia desde varias redes, registre las marcas de tiempo, los ID de solicitud, los mensajes de error y los nombres de usuario afectados, y luego abra un caso de soporte de Salesforce. Si solo una oficina está afectada, compare con otra red o conexión móvil antes de reportar una interrupción global del SaaS.
Si la interfaz de usuario de Salesforce funciona, pero las integraciones fallan, revise el punto final externo, la resolución DNS, los certificados, las colas, los códigos de error de la API y la región de la nube que aloja esa dependencia. No espere a que Salesforce publique un incidente sobre un componente que no gestiona.
Si el problema involucra recursos de AWS de su propiedad, utilice el panel de estado de AWS (con sesión iniciada) en lugar de confiar únicamente en el panel público. La documentación de AWS indica explícitamente que la información de estado específica de la cuenta puede diferir de la vista del servicio público. Consulte la documentación del panel de estado de AWS .
¿Cómo se puede saber cuándo se ha resuelto realmente el problema?
Que la página de estado vuelva a estar en verde es útil, pero la recuperación operativa debe confirmarse con su propio flujo de trabajo.
Antes de declarar finalizado el incidente, verifique que:
Los usuarios pueden iniciar sesión normalmente;
Las lecturas y escrituras de registros se realizan correctamente;
Los índices de error de la API han vuelto a los niveles iniciales;
Las integraciones en cola están consumiendo recursos en lugar de seguir acumulándose;
Los trabajos programados se están ejecutando de nuevo;
No queda activa ninguna configuración manual de conmutación por error ni de emergencia;
Las transacciones críticas para el negocio pueden completarse de principio a fin.
Un buen resultado no es simplemente que "el proveedor diga que está resuelto", sino que "el proveedor diga que está resuelto y que los flujos de trabajo que nos importan vuelvan a funcionar sin tasas de error anormales".
¿Cuál es la respuesta práctica en este momento?
Al 16 de septiembre de 2026, la información oficial disponible no respalda la afirmación de que Salesforce en su totalidad esté inactivo debido a la reciente interrupción de AWS. La interrupción más grave de AWS es específica de una región, centrada en Bahréin y partes de los Emiratos Árabes Unidos. Salesforce utiliza AWS para muchos entornos Hyperforce, incluso en los Emiratos Árabes Unidos, por lo que algunas cargas de trabajo alojadas o conectadas a Salesforce pueden tener dependencias de AWS. Esto hace que la verificación regional sea importante, pero no implica automáticamente una interrupción global de Salesforce.
Si su organización está experimentando problemas en este momento, el camino más confiable es:
Identifique su instancia de Salesforce;
Verifique esa instancia en Salesforce Trust;
Identifique si la organización o la dependencia que está fallando se encuentra en AWS y en qué región;
comparar los intervalos de tiempo exactos del incidente;
Pruebe el núcleo de Salesforce por separado de las integraciones externas;
Si la información oficial no explica sus síntomas, presente pruebas que puedan dar lugar a un informe más detallado.
Este enfoque ofrece una respuesta fundamentada para su propio entorno, en lugar de basarse en una suposición general. La limitación radica en que las páginas de estado públicas no pueden revelar de inmediato todos los fallos específicos de cada inquilino, por lo que la confirmación final de un incidente en producción podría requerir la asistencia del proveedor y su propia telemetría.