Inicio
» Cómo
»
Cómo iniciar Ubuntu Server en modo de emergencia: Guía de recuperación paso a paso
Cómo iniciar Ubuntu Server en modo de emergencia: Guía de recuperación paso a paso
Escenario ilustrativo: Casey mantiene una máquina virtual hipotética de Ubuntu Server que entra en modo de emergencia tras un reinicio, poco después de que se añadiera un montaje de volumen de datos opcional /etc/fstab. Casey tiene acceso a la consola, pero no a una sesión SSH. El cambio de montaje es una pista, no una causa probada: el modo de emergencia puede producirse tras varios fallos de arranque, por lo que Casey revisa los registros de la máquina actual antes de realizar cualquier cambio. Los paneles de terminal que se muestran a continuación presentan diseños representativos y resultados de ejemplo, no una reparación ni una prueba reales.
Qué significa el modo de emergencia
En una instalación de Ubuntu Server que utiliza systemd, emergency.targetinicia un shell mínimo en la consola principal. Es más limitado que rescue.target, que inicia el sistema base y los puntos de montaje del sistema con solo los servicios esenciales. Dependiendo de la ruta al modo de emergencia, el sistema de archivos raíz puede estar montado en modo de solo lectura o de lectura y escritura. Compruébelo en lugar de asumir cualquiera de los dos estados. Consulte la documentación de systemd special-target de origen .
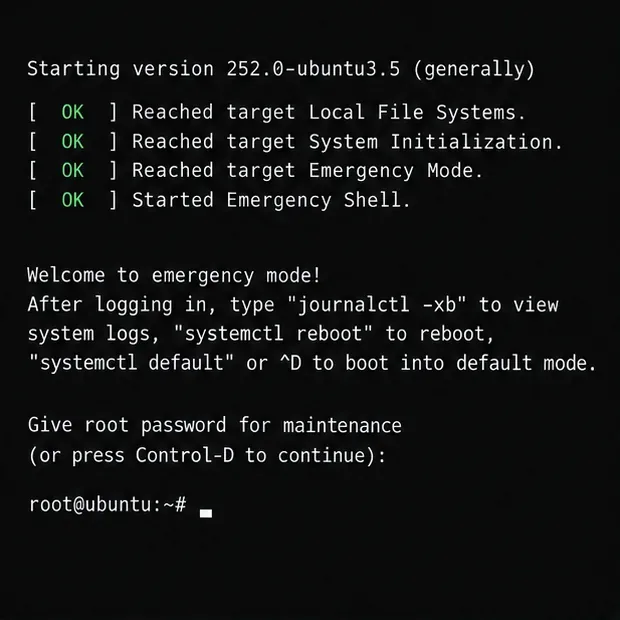
Primero, identifique el mensaje. Un shell de emergencia de systemd normalmente dice "¡Bienvenido al modo de emergencia!" y puede solicitar la contraseña de root para mantenimiento. Un mensaje de BusyBox como (initramfs)significa que el arranque aún no ha cambiado al sistema de archivos raíz instalado; un mensaje grub>o grub rescue>indica un problema con el gestor de arranque. Estos requieren diferentes rutas de recuperación. Si la cuenta de root está bloqueada o el servidor es remoto, utilice la consola serie/VNC o el entorno de rescate del proveedor de alojamiento; SSH generalmente no está disponible en esta etapa. No presione Ctrl+D para continuar hasta que comprenda y solucione el fallo reportado.
Rescate paso a paso
1. Mantenga el acceso a la consola y registre el fallo exacto.
Permanezca en la consola de emergencia. Anote el nombre del último montaje o servicio que falló, así como la ruta del dispositivo o el UUID que aparezca sobre el indicador. fstabVale la pena revisar la edición reciente de Casey, pero no comente todas las líneas que fallan ni ejecute un comando de reparación basándose únicamente en la palabra "emergencia". Si el sistema es una máquina virtual, mantenga abierta la consola del proveedor durante la reparación y el siguiente reinicio.
La consola identifica el modo de emergencia de systemd y proporciona un intérprete de comandos de mantenimiento; la autenticación y la redacción pueden variar según la configuración.
2. Lea el registro de arranque actual y las unidades que fallaron.
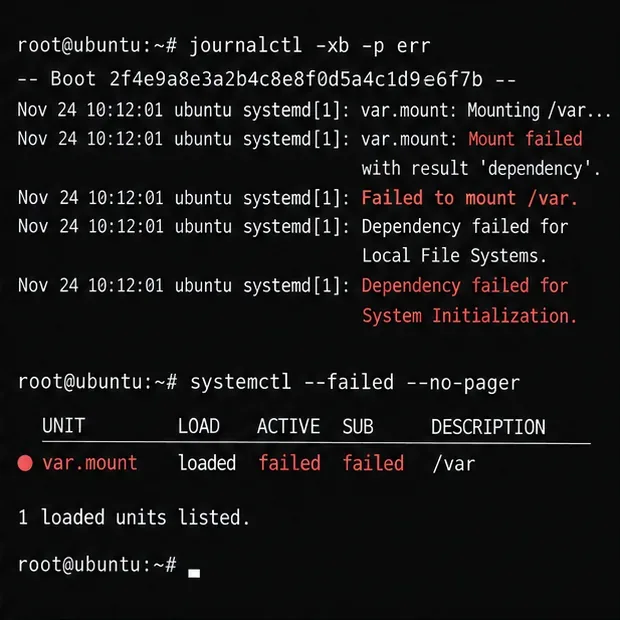
-bLimita la consulta del registro a este arranque y -p errfiltra por prioridad de error o superior. Busca el primer error relevante, no solo la última cascada de mensajes de "fallo de dependencia". Si una unidad de montaje falla, anota su nombre de unidad escapado y la ruta de destino; si un servicio falla, identifica si es la causa o solo una consecuencia de un montaje faltante. journalctl(1)El manual de Ubuntu documenta el filtrado de arranque y de unidades.
La salida representativa del registro de arranque apunta a una dependencia de montaje fallida; el nombre de la unidad y el mensaje reales deben provenir del servidor.
3. Compruebe el montaje raíz y el espacio disponible.
Antes de editar archivos o intentar reparaciones, inspeccione cómo está montado el sistema de archivos raíz y si el sistema se ha quedado sin bloques o inodos:
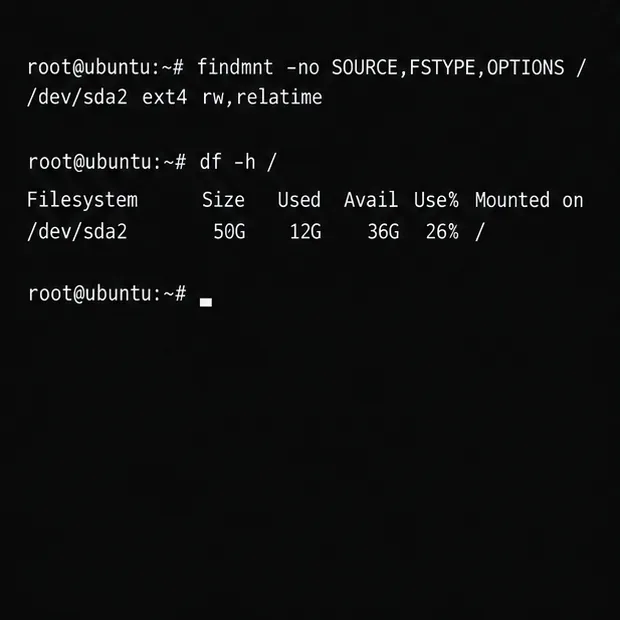
En la findmntsalida, rosignifica solo lectura y rwsignifica lectura y escritura. Una raíz de solo lectura puede ser intencional durante parte de una ruta de recuperación, o puede reflejar problemas en el sistema de archivos. No fuerce inmediatamente un remontaje como lectura y escritura si los registros del kernel informan errores de E/S o del sistema de archivos. Un sistema de archivos lleno o una tabla de inodos agotada también pueden provocar que fallen servicios y montajes no relacionados. El findmnt(8)manual de Ubuntu describe cómo inspeccionar los sistemas de archivos montados.
Los comandos revelan si la partición raíz está montada en modo de solo lectura o de lectura y escritura, y si hay bloques de disco disponibles.
4. Validar /etc/fstaby verificar los identificadores del dispositivo.
Dado que Casey realizó cambios recientemente /etc/fstab, verifique tanto su sintaxis como la existencia de los dispositivos a los que se hace referencia:
findmnt --verify --verbose
lsblk -f
blkid
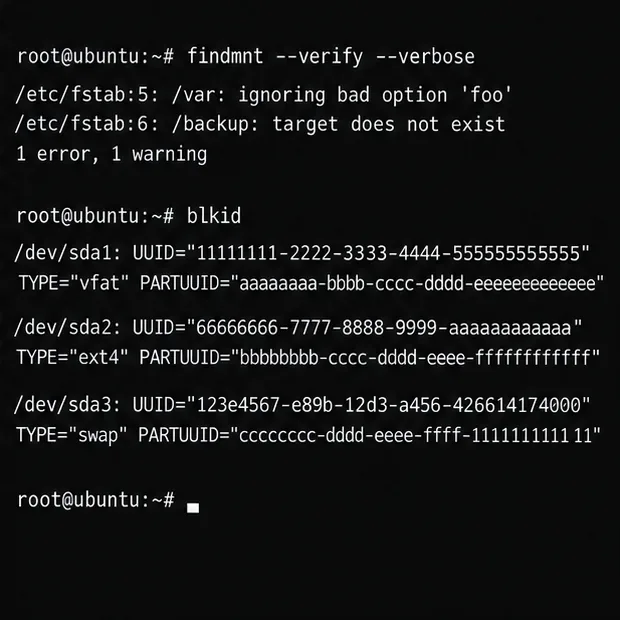
findmnt --verify --verboseComprueba las entradas de fstab en busca de problemas de análisis y usabilidad. Compara cada entrada UUID=de la fila sospechosa con el UUID que muestra lsblk -fo blkid. Comprueba también el punto de montaje, el tipo de sistema de archivos y las opciones. Un UUID copiado de otro disco, un dispositivo que no está conectado o una opción no válida pueden impedir que se complete un montaje necesario. No intentes adivinar una partición como /dev/sda1; los nombres de los dispositivos pueden cambiar entre arranques.
El validador informa sobre problemas con fstab, mientras que blkid enumera los UUID de los dispositivos para compararlos con la entrada sospechosa.
5. Corrija únicamente el problema de montaje confirmado.
Si el sistema de archivos raíz es escribible y la comprobación de fstab identifica una fila defectuosa, haga una copia de seguridad antes de editar:
cp -a /etc/fstab /etc/fstab.before-rescue
nano /etc/fstab
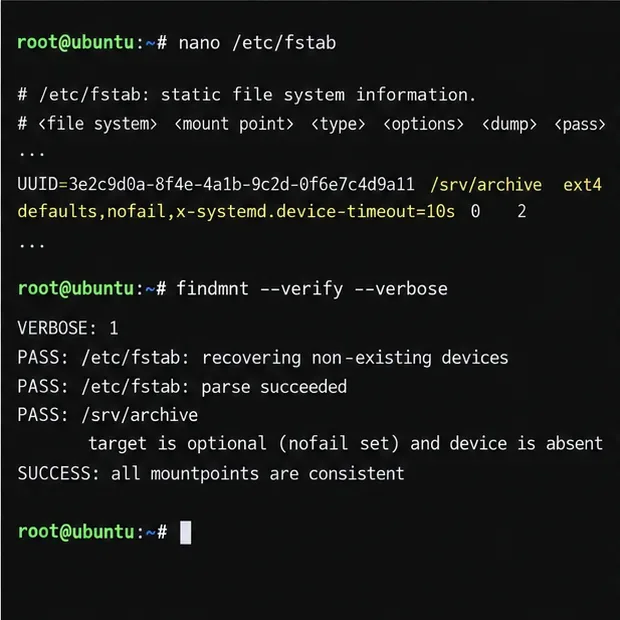
Corrija el UUID u otro campo solo después de confirmar el dispositivo previsto. Si el montaje es realmente opcional y el servidor debe arrancar incluso cuando ese volumen no está presente, se puede usar una línea fstab compatible con systemd nofaily una espera de dispositivo finita, por ejemplo:
Reemplace el marcador de posición con el UUID real y utilice el tipo de sistema de archivos real. No agregue nofaila la raíz, arranque u otros sistemas de archivos necesarios para que la máquina o sus aplicaciones funcionen correctamente. Con nofail, el arranque continúa incluso si falla el montaje, por lo que los servicios dependientes aún pueden requerir atención. El manual de la unidad de montaje de systemd de Ubuntu documenta estas opciones de fstab.
Tras editar, vuelva a validar antes de intentar el montaje:
findmnt --verify --verbose
systemctl daemon-reload
mount /srv/archive
Utilice el punto de montaje real en el último comando. Si aún así falla, lea el nuevo error y compruebe si el disco está conectado y en buen estado. Si el sistema de archivos raíz es de solo lectura, no fuerce cambios a ciegas; utilice un entorno de recuperación del proveedor o un medio de arranque de Ubuntu para inspeccionar y editar el sistema instalado de forma segura.
El ejemplo marca únicamente un montaje de archivo no esencial como opcional y comprueba el archivo fstab posteriormente.
6. Investigue un servicio fallido solo cuando el registro apunte a uno.
El modo de emergencia no significa que todos los servicios que fallaron hayan provocado la detención del arranque. Si el error correspondiente menciona un servicio, inspeccione esa unidad y sus registros en lugar de ocultarla o deshabilitarla:
systemctl status example.service --no-pager
journalctl -u example.service -b --no-pager
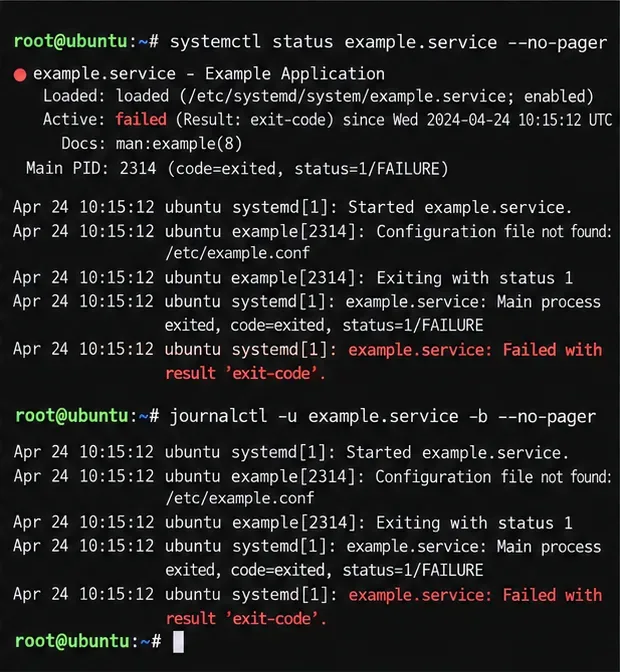
Sustituya example.servicepor el nombre exacto de la unidad. Compruebe si falta su archivo de configuración, ejecutable, credenciales o punto de montaje necesario. Si el fallo se debe a la falta del volumen de datos de Casey, solucione primero ese punto de montaje y luego vuelva a evaluar el servicio. Deshabilitar un servicio esencial puede ocultar el problema y dejar el servidor inutilizable.
El estado del servicio y el registro ayudan a diferenciar la causa raíz de los fallos provocados por otra dependencia faltante.
7. Tratar los errores del sistema de archivos como una tarea de reparación sin conexión.
Si el registro del kernel informa corrupción del sistema de archivos o errores de E/S de almacenamiento, detenga las escrituras cuando sea posible y conserve una copia de seguridad o una instantánea del proveedor antes de la reparación. Confirme el dispositivo y el sistema de archivos exactos con lsblk -f. Para un sistema de archivos raíz, arranque en el sistema de rescate del proveedor o en el medio de recuperación/en vivo de Ubuntu, asegúrese de que la partición de destino esté desmontada y utilice el verificador apropiado para ese sistema de archivos. Para ext2/3/4, esa herramienta es e2fsck; XFS, Btrfs y otros formatos tienen procedimientos diferentes.
Nunca ejecute fsckcomandos e2fscken un sistema de archivos montado, incluyendo una raíz montada de solo lectura. El e2fsck(8)manual de Ubuntu advierte que comprobar un sistema de archivos montado generalmente no es seguro y que los resultados no son válidos. Si el disco informa errores de E/S repetidos, priorice la recuperación de datos o la comunicación con el proveedor de almacenamiento antes que intentar reparaciones repetidamente.
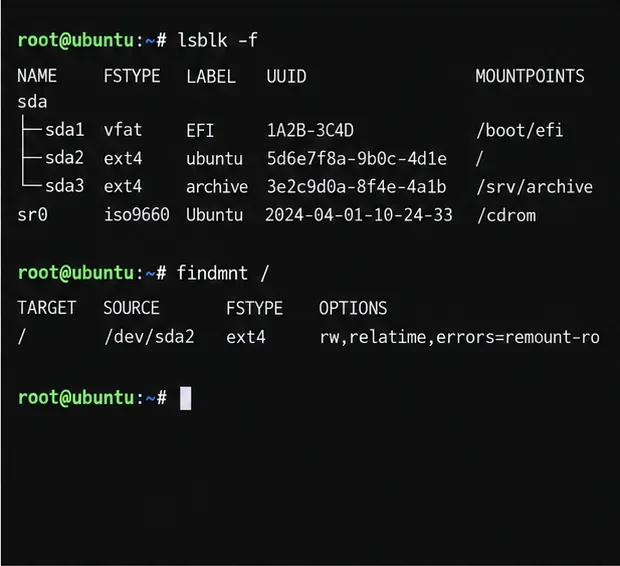
El listado de discos ayuda a identificar la partición correcta; el sistema de archivos raíz permanece montado, por lo que no está listo para ejecutar fsck.
8. Vuelva al arranque normal y verifique el resultado.
Una vez corregida la causa confirmada, reinicie desde la consola:
systemctl reboot
Después de que Ubuntu se inicie, compruebe el destino predeterminado configurado, el estado actual del sistema, las unidades que fallaron y el nuevo arranque:
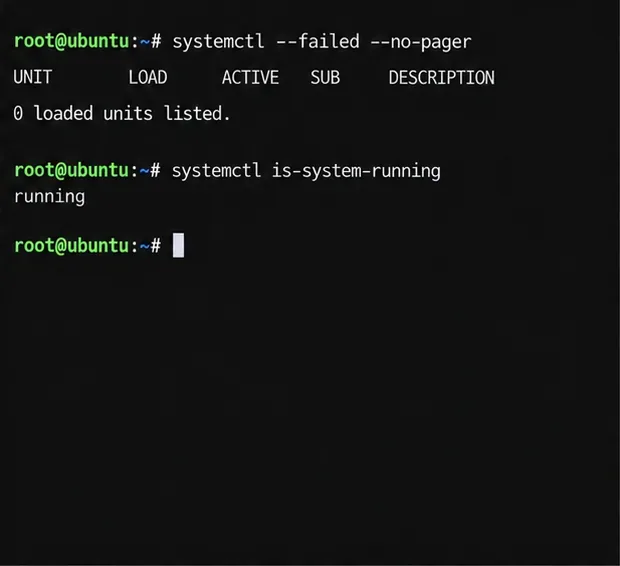
Si desea continuar intencionalmente en el arranque actual, systemctl defaultsolicite a systemd que inicie el destino predeterminado configurado. Úselo solo después de que se haya solucionado el error de bloqueo; no repara un montaje no válido ni un sistema de archivos dañado. systemctl get-defaultMuestra el destino predeterminado configurado; systemctl is-system-runninginforma si systemd considera que el estado actual está en ejecución, degradado o de otra manera. Una recuperación limpia significa que los sistemas de archivos esperados están montados, los servicios necesarios están activos y la misma condición de emergencia no se repite después del reinicio.
La terminal muestra las comprobaciones de systemctl para detectar unidades fallidas y si el sistema está funcionando después del reinicio.
Si la indicación es (initramfs)en cambio
No aplique los pasos de systemd emergency-shell a ciegas en BusyBox initramfs. La etapa initramfs intenta localizar y montar el sistema de archivos raíz real antes de ceder el control al sistema instalado. Registre el error exacto, compruebe si el dispositivo esperado aparece en /devy /dev/disk/by-uuid, y compare el valor de la línea de comandos de arranque root=con el UUID raíz real. Si falta el disco o el volumen cifrado/LVM, utilice las herramientas de almacenamiento y recuperación del proveedor para investigarlo. Reconstruir initramfs o cambiar los parámetros de GRUB sin identificar el dispositivo que falta puede dificultar la recuperación del arranque.
Para la máquina virtual hipotética de Casey, el resultado útil consiste en una causa verificada y una corrección específica: restaurar el volumen opcional esperado, corregir su identificador confirmado o configurarlo como opcional solo si la carga de trabajo lo permite. Luego, verificar el siguiente arranque desde la consola antes de cerrar la sesión de recuperación.