Inicio
» Cómo
»
Construya primero un clúster SLES de 15 HA con soporte y cercado.
Construya primero un clúster SLES de 15 HA con soporte y cercado.
Para SLES 15, registre la extensión SUSE Linux Enterprise High Availability y, a continuación, utilice crm cluster inity crm cluster joinpara inicializar los nodos. Antes de implementar servicios en el clúster, verifique la redundancia de red, el aislamiento de nodos (STONITH) y el quórum.
Este procedimiento sigue la documentación de SLE HA 15 SP7 vigente en octubre de 2026. Confirme el paquete de servicio instalado y la arquitectura de la CPU; los identificadores de registro y los detalles de soporte pueden variar.
1. Preparar los nodos y la red.
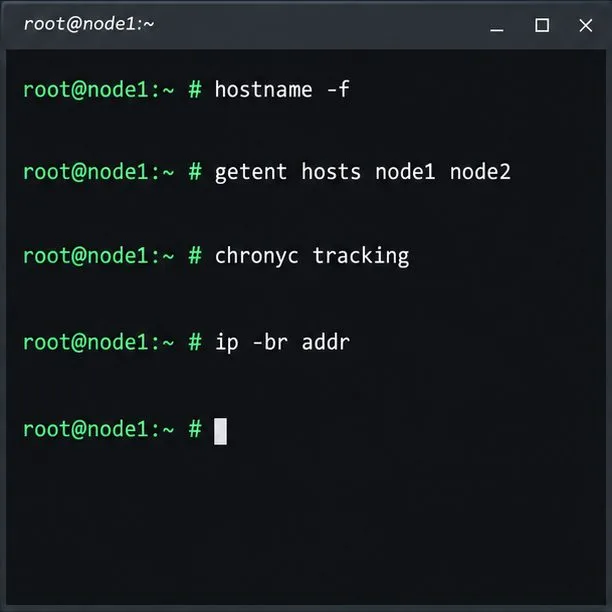
Antes de formar el clúster, compruebe la nomenclatura de host, la resolución de nombres, la sincronización horaria y el estado de la interfaz en cada nodo.
Utilice al menos dos nodos con la misma arquitectura de procesador compatible, direcciones IP primarias estáticas, nombres únicos que se puedan resolver en cada nodo y relojes sincronizados mediante una fuente de tiempo externa. SUSE requiere dos rutas de comunicación TCP/IP redundantes por nodo; los nombres de las interfaces deben coincidir en todos los nodos.
Ejecute las comprobaciones en ambos nodos y confirme que las interfaces y los nombres seleccionados sean correctos antes de iniciar el arranque.
2. Registre e instale la extensión de alta disponibilidad.
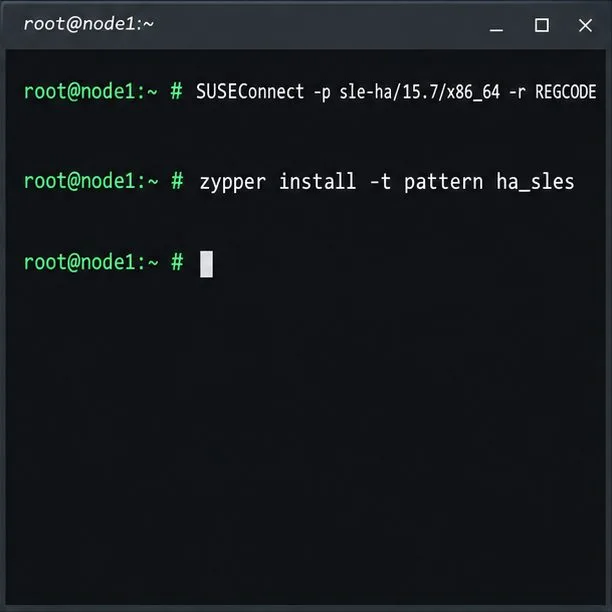
En cada nodo, registre la extensión SLE HA e instale su patrón de administración de clúster.
SLE HA es una extensión registrada por separado; SLES por sí solo no incluye el patrón de clúster. Para los nodos SLES 15 SP7 x86_64 registrados, habilite la extensión e instale el patrón en cada nodo:
Sustituya ADDITIONAL_REGCODEcon su código de suscripción. El identificador del producto es para x86_64; utilice el identificador correspondiente de SUSE para otras arquitecturas. Mantenga todos los nodos en el mismo nivel de SLES SP y SLE HA. Consulte la guía de instalación de SUSE SLE HA 15 SP7 .
3. Decida el cercado y el quórum antes de la inicialización.
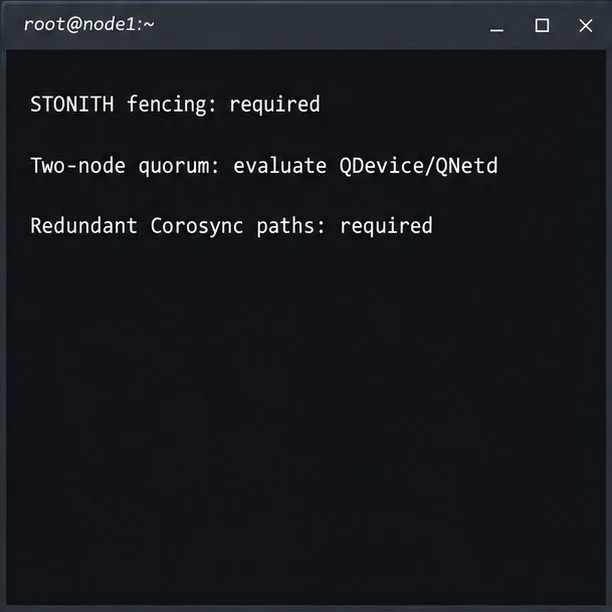
El vallado es un requisito de soporte; un clúster de dos nodos también debe diseñarse teniendo en cuenta el comportamiento del quórum.
Requerido para clústeres compatibles: aislamiento de nodos (STONITH), con stonith-enabledy startup-fencingdejado en verdadero. El aislamiento protege un nodo inestable para evitar que ambos lados de una partición ejecuten el mismo servicio. Elija un dispositivo de control de energía o SBD compatible con un temporizador de vigilancia probado para su hardware o hipervisor.
Para dos nodos: SUSE recomienda QDevice/QNetd para clústeres con un número par de nodos. Agrega una votación de quórum independiente, no un sistema de aislamiento; configure primero el servidor QNetd por separado si incluye QDevice durante el arranque. Consulte la guía de QDevice y QNetd .
Concepto erróneo sobre el almacenamiento: el almacenamiento compartido no es obligatorio para todos los clústeres, pero los datos de las aplicaciones necesitan su propio diseño compartido, replicado o recuperable. Pacemaker mueve recursos; no copia datos de las aplicaciones.
4. Inicializar el primer nodo
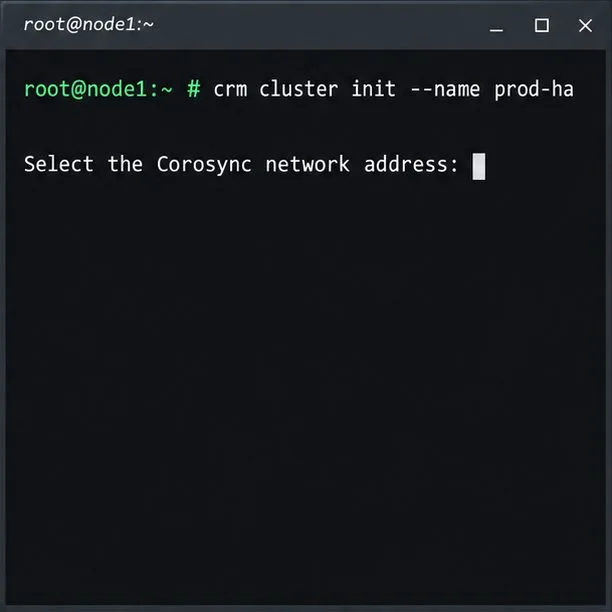
El script de arranque se inicia en el nodo 1 y solicita la dirección de red que debe usar Corosync.
En node1, inicie el arranque de CRM Shell como root o a través de la configuración de sudo-user aprobada:
crm cluster init --name prod-ha
Siga las instrucciones y seleccione la dirección Corosync deseada. El script configura Corosync, SSH, Csync2, los puertos del firewall del clúster y Hawk2; verifica la sincronización horaria y ofrece SBD opcional y una IP de administración de Hawk2. Revise /var/log/crmsh/crmsh.logla configuración de arranque.
Configure el sistema de vigilancia en cada nodo antes de seleccionar SBD. Si utiliza aislamiento externo, configure el recurso STONITH compatible antes de ejecutar las cargas de trabajo. Nunca desactive STONITH para solucionar la falta de un dispositivo. Bootstrap crea un clúster básico, no una aplicación de alta disponibilidad.
5. Conéctate al segundo nodo.
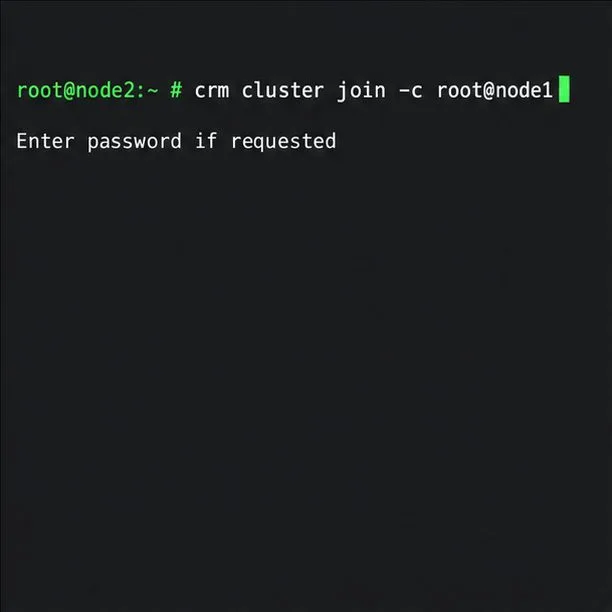
Ejecute el comando join en node2; utilice las mismas opciones de interfaz de red que se seleccionaron durante la inicialización.
Instale y registre SLE HA en el nodo2. Si utiliza SBD, prepare su temporizador de vigilancia allí antes de unirse. Luego, como root:
crm cluster join -c root@node1
Para la configuración de un usuario con permisos de administrador, utilice USER@NODE1el procedimiento de SUSE. Especifique las mismas dos interfaces si se configuraron durante la inicialización. El script copia la configuración de Corosync, configura SSH y Csync2, y pone en línea el nodo 2. Repita el proceso para los demás nodos; no combine los métodos de arranque con los de configuración de YaST.
6. Confirmar la membresía y asegurar la administración.
Verifique la membresía con el estado de CRM y reemplace la contraseña de bootstrap hacluster antes de usar Hawk2.
Desde un nodo del clúster, compruebe la pertenencia:
crm status
Verifique que ambos nodos estén en línea y que haya quórum. El arranque se crea haclustercon la contraseña inicial linux; cámbiela en cada nodo inicializado:
passwd hacluster
Hawk2 utiliza HTTPS en el puerto 7630. Verifique el certificado autofirmado con su administrador antes de confiar en él. La IP de administración de Hawk2 no es la dirección del cliente de la aplicación.
7. Añada recursos para el servicio que realmente necesita proteger.
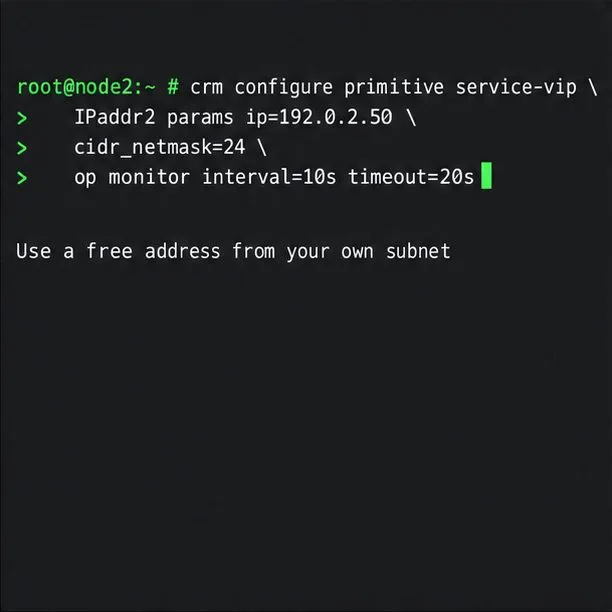
El ejemplo define únicamente un recurso IP flotante; sustituya la dirección que aparece en la documentación por una dirección no utilizada de su subred.
Pacemaker gestiona los servicios mediante agentes de recursos. Instale y configure la carga de trabajo adecuadamente en los nodos elegibles. Este ejemplo crea únicamente una primitiva de IP flotante:
192.0.2.50Está reservado para documentación. Sustituya una dirección libre y el prefijo correcto de su subred. Una primitiva IP no inicia una aplicación ni replica datos. Añada el agente compatible con la aplicación, además del ordenamiento, la ubicación y el comportamiento de almacenamiento específicos de la carga de trabajo; siga las instrucciones de recuperación y protección del producto.
8. Pruebe la conmutación por error antes de declarar que el clúster está listo.
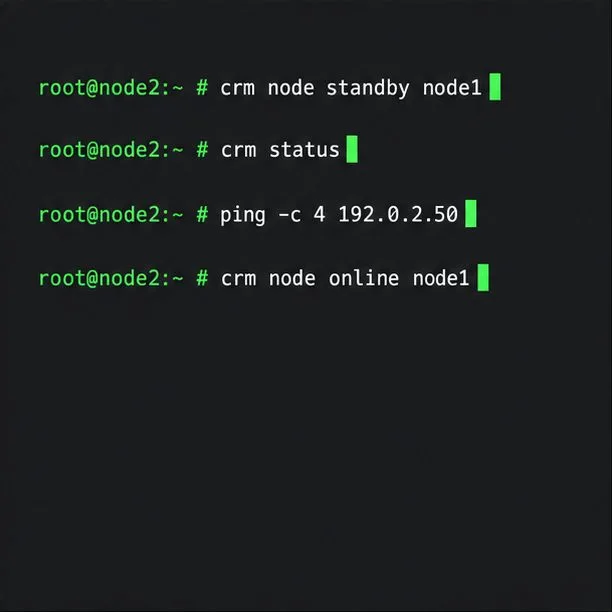
Una prueba de espera planificada verifica que el recurso se mueva y, a continuación, vuelve a poner el nodo en servicio.
Tras configurar los recursos reales y el aislamiento, programe una prueba de conmutación por error controlada. Ponga el nodo 1 en modo de espera y compruebe el servicio desde el nodo 2:
Reemplazar SERVICE_VIPcon la dirección real del cliente. Confirmar que la aplicación responde, que los recursos se mueven como se espera y que el nodo1 se vuelve a unir. La comprobación de ping solo verifica la accesibilidad de la red. SUSE crm cluster crash_testinterrumpe intencionadamente los componentes, así que úselo en un entorno de prueba planificado. Lea la guía de inicio rápido y de aislamiento de la instalación de SLE HA .
Verificar la disponibilidad del servicio
Tras las pruebas, confirme que ambos nodos tienen el estado esperado, que el aislamiento permanece habilitado y que la carga de trabajo responde a través de su punto final de cliente una vez que el nodo 1 vuelve a estar en línea. Una visualización de membresía en verde o un ping exitoso por sí solos no demuestran la recuperación de la aplicación.