Inicio
» Cómo
»
Diagnosticar un servidor SUSE que se bloquea en la pantalla de apagado de systemd.
Diagnosticar un servidor SUSE que se bloquea en la pantalla de apagado de systemd.
Si SUSE Linux Enterprise Server se bloquea durante el apagado de systemd, identifique la unidad con una tarea de detención en ejecución o examine los mensajes finales del arranque anterior y, a continuación, solucione el problema en esa unidad o en sus dependencias. Una unidad es un recurso gestionado por systemd, como un servicio o un punto de montaje; una tarea de detención es la solicitud de systemd para apagarlo. No reduzca el tiempo de espera global ni fuerce el apagado como primera solución, ya que un servicio o sistema de archivos podría seguir cerrando archivos o escribiendo datos.
Este tutorial se basa en la documentación de SLES 15 SP7 revisada en octubre de 2026. La política de detención exacta depende del proveedor de servicio y almacenamiento, por lo que deberá consultar sus instrucciones para cualquier cambio específico de la unidad.
1. Observe el apagado de forma segura.
Paso 1: Grabe el mensaje exacto y espere a obtener pruebas útiles.
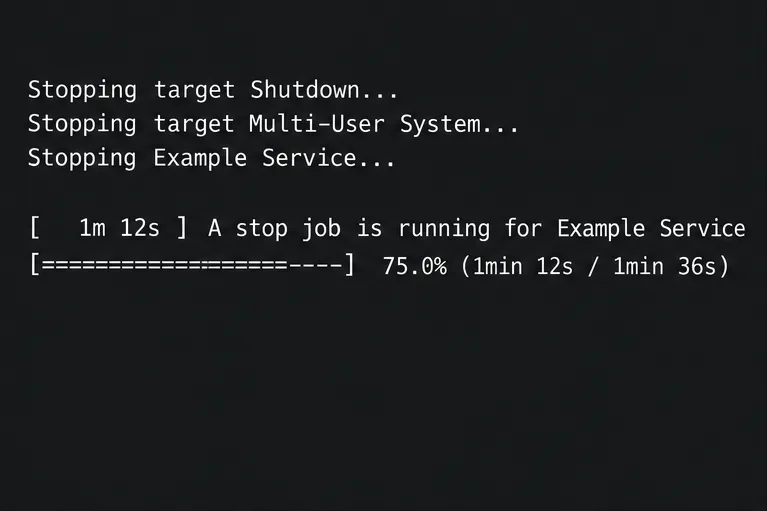
Si la consola muestra el mensaje "Se está ejecutando una tarea de detención durante..." con una cuenta regresiva, anote el nombre del servicio o punto de montaje y si el temporizador cambia. Esto significa que systemd está esperando que finalice la operación de detención de esa unidad, no necesariamente que el sistema operativo haya fallado; las bases de datos y el almacenamiento remoto pueden necesitar tiempo para cerrarse correctamente.
Un ejemplo de mensaje de consola indica la unidad que systemd está esperando; el servicio y la cuenta regresiva que se muestran son solo ilustrativos.
Observe el sistema mediante la consola remota o serie, u otro terminal disponible. Evite reiniciar o encender el equipo mientras se estén realizando operaciones de escritura. Si el sistema deja de responder, registre la última línea visible y continúe después del arranque.
2. Encuentra la unidad que está esperando
Paso 2: Inspeccione los trabajos de systemd para comprobar si la máquina sigue aceptando comandos.
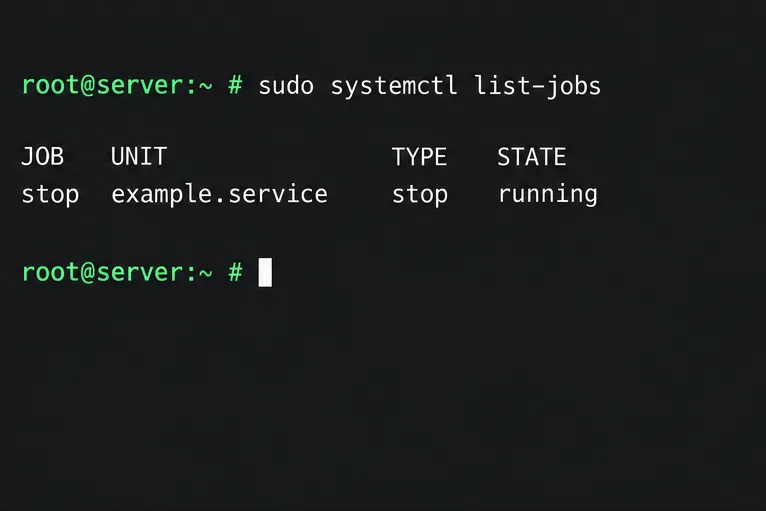
Si SSH o una segunda terminal aún funcionan, pregunte a systemd qué trabajos se están ejecutando o esperando, y luego verifique la unidad nombrada en la pantalla:
sudo systemctl list-jobs
sudo systemctl status SERVICE.service
La lista de tareas puede identificar un servicio cuya operación de parada aún está en curso; la fila que se muestra es un ejemplo.
Sustituya SERVICEcon el nombre real de la unidad. Una tarea de detención en ejecución reduce la búsqueda, pero no explica por qué el proceso no ha finalizado. Lea su estado y los registros antes de modificar la configuración. Si systemd deja de responder, no cancele las tareas a ciegas; inspeccione el registro anterior una vez que el host responda.
3. Utilice el arranque anterior para identificar la causa.
Paso 3: Lee el final del diario de la bota anterior.
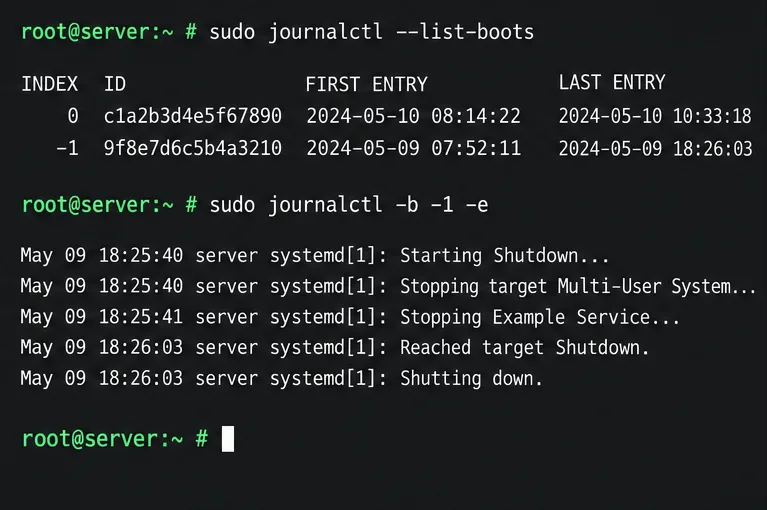
El registro es el archivo indexado de systemd que contiene los mensajes del kernel, los servicios y el sistema. Tras el siguiente inicio exitoso, liste los arranques registrados e inspeccione el final del anterior:
El -1desplazamiento selecciona el arranque anterior y -ese mueve a sus entradas más recientes.
Busque el último mensaje de "Deteniendo", un tiempo de espera agotado, reintentos o un dispositivo o montaje con nombre. La última línea es solo una pista: el orden de apagado puede dejar otra unidad esperando. Compare las marcas de tiempo y los mensajes cercanos.
Paso 4: Filtrar los registros del servicio sospechoso
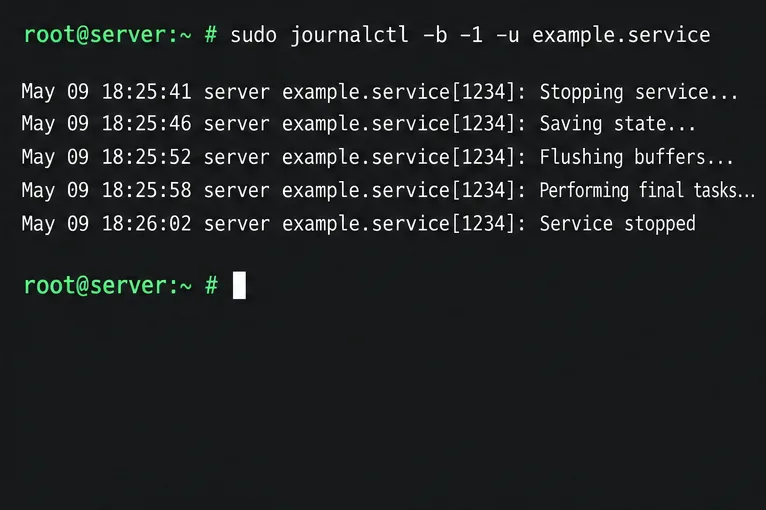
Cuando la pantalla o el registro muestren el nombre de un servicio, consulte únicamente las entradas de arranque anteriores de esa unidad. Revise también su configuración cargada:
El filtrado por unidad ayuda a distinguir un apagado lento del servicio de otros mensajes no relacionados que aparecen en otras partes del registro.
Verifique si hay ExecStopun script personalizado que espera indefinidamente, un proceso hijo persistente o un error de la aplicación en su gancho de cierre. Para unidades de proveedor, compare el paquete y la configuración con las directrices compatibles antes de editarlos.
Paso 5: Compruebe los soportes y el almacenamiento solo cuando la evidencia lo indique.
Si el registro nombra un punto de montaje, dispositivo o sistema de archivos remoto, inspeccione la tabla de montaje y la entrada correspondiente en /etc/fstab:
sudo findmnt --verify --verbose
Utilice la verificación de montaje cuando los registros indiquen que se trata de un montaje; las entradas mostradas son ilustrativas y deben compararse con las del host.
Compruebe si una dependencia remota NFS, CIFS, iSCSI u otra es accesible y esperada durante el apagado. Elimine una entrada de montaje obsoleta solo después de confirmar que no se utiliza. No fuerce el desmontaje de un sistema de archivos en funcionamiento basándose únicamente en un reinicio lento.
4. Soluciona la causa sin ocultarla.
Paso 6: Reparar el servicio o ajustar únicamente su política de interrupción documentada.
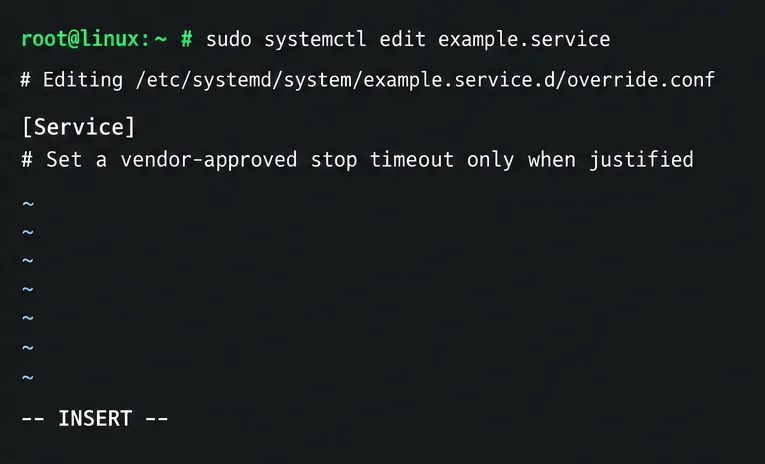
Para un servicio que no finaliza, primero solucione el problema de su script de apagado, configuración de la aplicación o paquete. sudo systemctl edit SERVICE.serviceSe almacena un archivo de configuración por unidad /etc/systemd/system/sin necesidad de editar el archivo del proveedor. Consulte la documentación de SUSE TimeoutSecpara iniciar o detener el servicio; utilice un valor aprobado por el proveedor para esta carga de trabajo.
Una unidad de inserción puede contener una anulación específica; la nota que se muestra es orientativa, no un valor de tiempo de espera.
Tras una edición documentada, recargue las definiciones de unidades de systemd con sudo systemctl daemon-reloady examine el resultado con sudo systemctl cat SERVICE.service. Un tiempo de espera más largo puede permitir que un apagado legítimo finalice, pero también puede prolongar un reinicio fallido. Uno más corto puede terminar un servicio antes de que guarde su estado. No modifique la configuración global para ocultar el defecto de una unidad.
Paso 7: Conservar los registros para el próximo incidente.
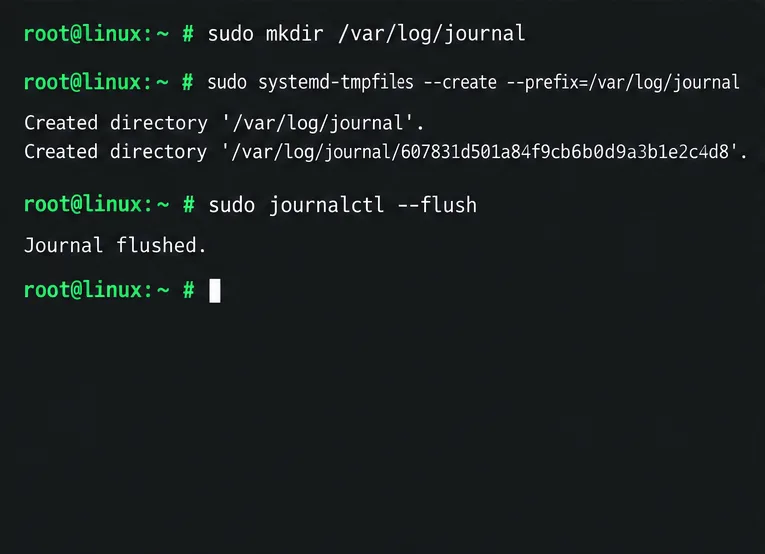
SLES almacena los datos del registro en /run/log/journal/un directorio volátil predeterminado, y este se borra al reiniciar. Si journalctl -b -1no tiene entradas de arranques anteriores, habilite el almacenamiento persistente del registro para diagnósticos futuros:
Estos comandos conservan las nuevas entradas del registro entre reinicios; no pueden restaurar los registros que ya se han perdido del almacenamiento volátil.
Los registros persistentes utilizan espacio en /var; SUSE indica que el registro puede utilizar hasta un 10 por ciento de ese sistema de archivos de forma predeterminada. Compruebe el espacio libre y la retención, especialmente en /varvolúmenes pequeños.
5. Verifique el próximo reinicio planificado.
Paso 8: Confirme que la detención se ha completado y que el servidor ha vuelto a estar operativo.
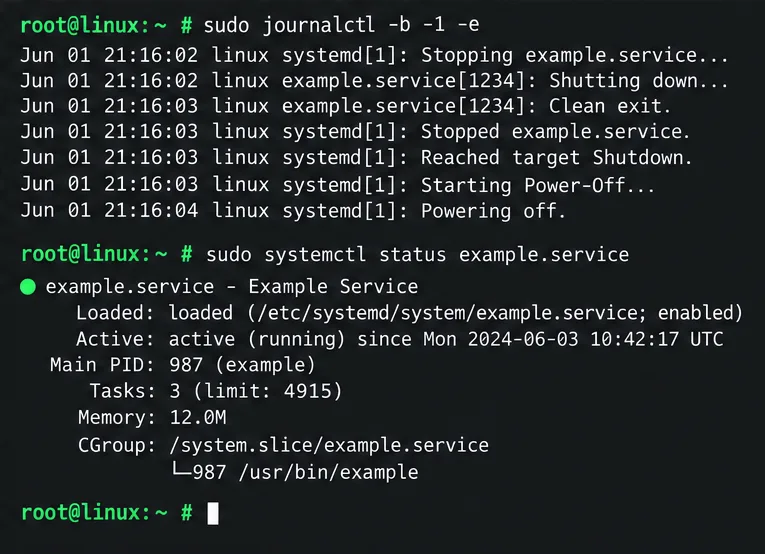
Una vez corregida la causa sospechada, programe un reinicio controlado con acceso a la consola. Tras el reinicio del equipo, revise los mensajes finales del arranque anterior y compruebe el estado actual del servicio.
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service
Tras un reinicio posterior, verifique que el apagado anterior haya llegado a sus mensajes finales y que el servicio vuelva a estar en buen estado; esta es una vista de ejemplo, no una evidencia de prueba.
El problema se resuelve cuando el servidor se apaga sin esperar en la misma unidad, arranca normalmente y el servicio o el montaje funcionan correctamente. Si los registros terminan abruptamente o muestran errores del kernel, del controlador o del hardware, consérvelos e investigue con SUSE o el proveedor del hardware en lugar de ajustar los tiempos de espera.
Para obtener detalles sobre los comandos, consulte la guía de systemd de SLES 15 SP7 y la guía de SUSE sobre registros persistentes y filtros journalctl . Estos pasos permiten identificar posibles problemas; la solución correcta (servicio, sistema de archivos o hardware) depende de la unidad identificada en los registros del propio equipo.