Inicio
» Tecnología
»
Interrupción del servicio de Salesforce en 2025: Una retrospectiva de las principales interrupciones
Interrupción del servicio de Salesforce en 2025: Una retrospectiva de las principales interrupciones
La conclusión más importante del historial de interrupciones de Salesforce en 2025 es que no hubo una única interrupción global que definiera el año. En cambio, los clientes experimentaron diferentes patrones de interrupción: una interrupción generalizada del servicio en febrero, fallos de autenticación en varias nubes en junio, un incidente importante en la plataforma Heroku causado por una actualización no deseada del proveedor, un evento en la red del centro de datos de Indianápolis y, posteriormente, incidentes limitados a instancias o funciones específicas. Esta distinción es importante porque la respuesta adecuada depende de la causa del fallo.
Si los usuarios no pueden iniciar sesión, actualizar el navegador no solucionará el problema. Si la página de estado público se retrasa, es posible que el monitor de interrupciones genérico esté incompleto. Si Salesforce está disponible, pero la cola de integración está bloqueada, el CRM puede parecer en buen estado mientras que los procesos de negocio siguen fallando. La lección práctica de 2025 es combinar notificaciones de estado específicas para cada inquilino, monitorización independiente, procedimientos manuales probados y una comprobación de recuperación para los sistemas posteriores.
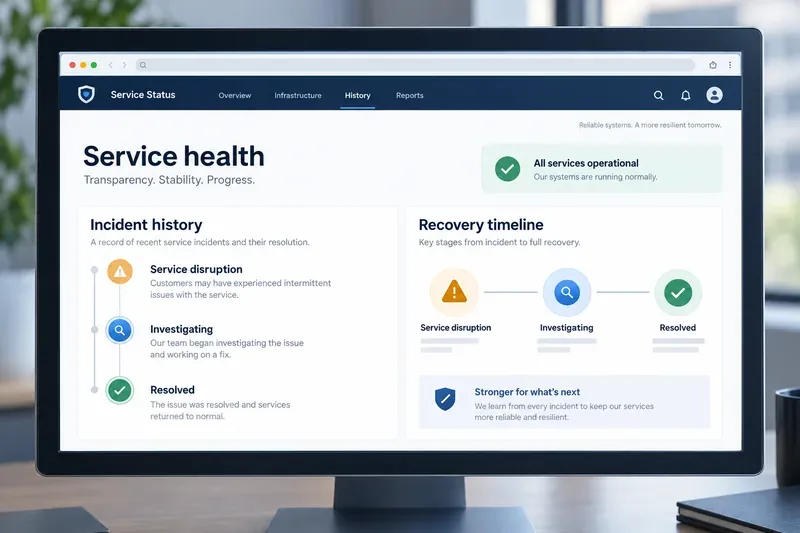
Un panel genérico de estado del servicio muestra las etapas que revisan los equipos al reconstruir la cronología de una interrupción; se trata de una ilustración conceptual, no de una captura de pantalla real de Salesforce.
¿Cuáles fueron las principales disrupciones que sufrió Salesforce en 2025?
Los siguientes incidentes son útiles para un análisis retrospectivo porque muestran diferentes modos de fallo. No se trata de una afirmación de que todos los eventos de estado de Salesforce en 2025 estén incluidos en esta lista.
Fecha
Ruptura
Lo que muestra el registro
Por qué es importante
7 de febrero
interrupción del servicio
Según el registro oficial del incidente, la interrupción finalizó a las 11:21 UTC y duró aproximadamente 2 horas y 20 minutos.
Un incidente generalizado en el servicio puede afectar al funcionamiento normal de Salesforce, incluso cuando la causa raíz no se detalle públicamente.
10 de junio
Fallos de autenticación entre nubes
Salesforce informó de que los servicios de autenticación de Heroku, Commerce, Marketing Cloud y los servicios de Salesforce se vieron afectados.
Las dependencias de inicio de sesión e identidad pueden provocar una interrupción del servicio en varios productos sin que todos los productos presenten el mismo fallo técnico.
10 de junio
Disrupción de la plataforma Heroku
Heroku atribuyó posteriormente el incidente a una actualización del sistema no intencionada aplicada a la infraestructura de producción por un proveedor. El sitio web de estado de Heroku también se vio afectado.
El canal de comunicación puede convertirse en parte del incidente, lo que hace que las vías de notificación independientes sean esenciales.
18 de junio
Interrupción de la red del centro de datos de Indianápolis
Salesforce informó que una falla en el sistema de refrigeración del centro de datos de Indianápolis afectó a las pilas 1 y 6.
Los incidentes relacionados con la infraestructura física pueden ser menos específicos que un apagón global, pero aun así resultar graves para las instancias afectadas.
1 de noviembre
Interrupción del servicio principal a nivel de instancia
El registro oficial del incidente identifica a IND76 como una instancia afectada y registra el evento como resuelto.
Las comprobaciones específicas de cada instancia son más útiles que depender únicamente de informes generales como "¿Está caído Salesforce?".
31 de diciembre
Degradación del rendimiento de la mensajería de WhatsApp
Salesforce informó de una afectación al rendimiento de la función de mensajería de WhatsApp en varias instancias y posteriormente confirmó que se había restablecido a las 16:56 UTC.
Una función puede verse afectada mientras que el resto del CRM sigue siendo utilizable.
Los incidentes del 10 de junio revelan dos niveles de fallas diferentes.
El 10 de junio es especialmente importante porque la "interrupción de Salesforce" puede abarcar más de un evento. El registro de confianza de Salesforce describió fallos en la autenticación multifactor que afectaron a varias nubes. El informe posterior de Heroku sobre las medidas correctivas describió una interrupción del servicio de la plataforma que comenzó a las 06:00 UTC y fue causada por una actualización del sistema no intencionada aplicada a la infraestructura de producción por un proveedor.
Heroku también reconoció que su sitio de estado se vio afectado. Según la actualización de acciones correctivas de Heroku , las deficiencias en el diseño de la página de estado y la latencia de la API provocaron tiempos de espera agotados, y la página podía mostrar que no había incidentes activos. Heroku indicó que respondió con controles que incluyen la suspensión permanente de las actualizaciones desatendidas del sistema operativo del proveedor, auditorías de imágenes, monitoreo adicional, almacenamiento en caché del contenido de estado, planificación de comunicaciones independiente y procedimientos de respuesta a incidentes más rigurosos.
Esta distinción es crucial para los administradores. La página de estado no es el servicio en sí, sino que los clientes la utilizan para decidir si esperar, realizar una conmutación por error, abrir un caso de soporte o comunicarse con sus propios usuarios. Si el canal de estado comparte demasiada infraestructura con la plataforma afectada, es posible que no proporcione información fiable en el momento más necesario.
¿Qué lecciones dejó el récord de 2025 a los clientes de Salesforce?
1. La autenticación merece su propio plan de continuidad.
Un equipo puede tener datos de aplicación correctos y aun así no poder trabajar si falla el inicio de sesión, la autenticación multifactor o la conexión de identidades. Esto es especialmente importante para las empresas que utilizan Salesforce, Heroku, Commerce y Marketing Cloud conjuntamente. Documente qué usuarios necesitan acceso a qué sistemas, identifique contactos de emergencia que puedan recibir actualizaciones de los proveedores y defina qué tareas pueden continuar sin un inicio de sesión exitoso.
Para un equipo de ventas pequeño, esto podría significar una lista de llamadas manual temporal y un registro de incidentes compartido. Para un centro de contacto o una operación de atención médica, podría requerir un procedimiento formal de interrupción del servicio, exportaciones de solo lectura aprobadas y un árbol de escalamiento probado. La magnitud del plan de contingencia debe ser proporcional a las consecuencias comerciales de un bloqueo.
2. Una página de estado genérica no es suficiente.
La propia documentación de Salesforce explica que el estado de confianza proporciona información sobre disponibilidad y rendimiento, mientras que las vistas más recientes de My Trust Center están diseñadas en torno a los inquilinos y los productos compatibles. El punto clave es sencillo: conozca su instancia o identificador de inquilino antes de que se produzca un incidente.
Salesforce también proporciona instrucciones para suscribirse a los mensajes y notificaciones de My Trust Center . Configure las notificaciones para las personas que deben actuar, no solo para el administrador que creó la organización. Mantenga un canal independiente, como una página de estado interna o un grupo de mensajería autorizado, para que su empresa pueda comunicarse incluso si el sitio de estado del proveedor está lento o no disponible.
3. La recuperación es más que ver la pantalla de inicio de sesión.
Cuando Salesforce informa que los servicios se han restablecido, el incidente aún puede tener repercusiones en el negocio. Una solicitud de API retrasada puede reintentarse dos veces, un mensaje en cola puede llegar tarde o una implementación fallida puede provocar que los registros no estén sincronizados. Tras la recuperación, compruebe los flujos de trabajo más importantes: autenticación, llamadas a la API, trabajos programados, colas de integración, envío de correos electrónicos o mensajes, creación de registros y actualización de informes.
Por ejemplo, imaginemos un equipo de soporte de tamaño mediano cuyos agentes utilizan casos de Salesforce, mientras que un sistema de comercio electrónico independiente envía actualizaciones mediante una integración. Si Salesforce vuelve a estar disponible a las 10:00 a. m., pero la cola de integración contiene mensajes fallidos correspondientes al período de inactividad, el equipo no debería cerrar el incidente simplemente porque el navegador se cargue. La prueba correcta consiste en verificar si las actualizaciones de casos, tanto nuevas como las que fallaron anteriormente, se procesan correctamente sin duplicación.
¿Qué medidas de continuidad se ajustan a su organización?
Situación empresarial
Mínimo práctico
Cuándo añadir más
Equipo pequeño; una breve interrupción es tolerable.
Suscríbase a las notificaciones de Trust pertinentes, registre el identificador de instancia y mantenga una breve lista de verificación para el trabajo manual.
Si el historial del cliente o los registros de cumplimiento son fundamentales, añada exportaciones y pruebas de recuperación.
Los ingresos, los centros de contacto y las operaciones de servicio dependen de Salesforce durante todo el día.
Utilice un sistema de monitorización independiente, un procedimiento para casos de inactividad, controles de reintento de integración y un responsable de incidentes designado.
Pruebe los canales de conmutación por error o de entrada alternativos durante el horario laboral antes de una interrupción real del servicio.
Salesforce está vinculado a Heroku o a varias nubes.
Supervise por separado la fuente de estado de cada producto y documente las dependencias de autenticación.
Realizar ejercicios conjuntos de recuperación que pongan a prueba el inicio de sesión, las API, las colas y las comunicaciones con los clientes de forma conjunta.
Datos regulados o de alto valor
Utilice un diseño de copia de seguridad y retención aprobado, controles de acceso, registros de auditoría y un manual de recuperación.
Haga revisar el manual de procedimientos por los departamentos de seguridad, legal, cumplimiento normativo y los propietarios del negocio.
Cómo utilizar esta retrospectiva en 2026 y más allá.
Comience con un mapa de dependencias de una página. Anote su instancia o inquilino de Salesforce, proveedor de identidad, nubes conectadas, integraciones críticas, suscripciones de estado y el proceso manual utilizado durante una interrupción. Luego, defina una verificación de recuperación objetiva para cada flujo de trabajo importante. Decir que "Salesforce ha vuelto" es demasiado vago; en cambio, "los nuevos casos, los mensajes salientes y las actualizaciones de pedidos se procesan sin duplicados" es algo que se puede comprobar.
Finalmente, revise los cambios que pueden afectar la disponibilidad: actualizaciones de proveedores, cambios en el sistema operativo, lanzamientos, cambios de configuración y migraciones de instancias. El incidente de Heroku de junio demuestra por qué los cambios no supervisados requieren controles rigurosos y por qué la comunicación de estado necesita su propia resiliencia. El evento del 18 de junio demuestra por qué la capacidad física y las dependencias del centro de datos siguen siendo importantes en un servicio en la nube. La degradación de funciones de diciembre demuestra por qué los equipos deben supervisar las funciones que realmente utilizan, no solo la disponibilidad general de la plataforma.
Por lo tanto, la respuesta más adecuada es condicional. Una organización pequeña puede necesitar notificaciones y una lista de verificación manual clara. Una empresa que no puede interrumpir las ventas ni el soporte necesita monitoreo independiente, recuperación con reconocimiento de cola y un proceso de inactividad probado. Una organización altamente regulada necesita restauración probada, evidencia y gobernanza. El historial de interrupciones de Salesforce de 2025 respalda una conclusión constante: la resiliencia se basa en la cadena de dependencia del cliente, no en un único indicador de estado verde.
Fuentes y alcance
Este análisis retrospectivo utiliza los registros de incidentes de Salesforce Trust y la documentación de Salesforce o Heroku disponible al momento de redactarlo. Las páginas de incidentes pueden actualizarse tras su resolución, y la cobertura de productos de Salesforce difiere entre Trust Status y My Trust Center. En los casos en que Salesforce no haya publicado un análisis detallado de la causa raíz, este artículo no lo infiere.