Comience por comprobar si las conexiones lentas afectan a una sala, a un servidor remoto o a todas las salas federadas. Utilice el estado y los registros de destino de la federación de Synapse para localizar fallos repetidos antes de modificar los tiempos de espera o añadir nodos de trabajo. Una conexión cruza los límites de los servidores y intercambia datos de autorización y estado de la sala, por lo que un servidor remoto lento o una sala grande pueden retrasar una conexión incluso cuando su propio servidor funciona correctamente.
La especificación de servidor a servidor de Matrix describe el protocolo make_joinde send_joinenlace y el estado que se devuelve a un servidor que se une. Esto significa que el "retraso de la federación" no es automáticamente un problema de la cola Synapse local. Las comprobaciones que se describen a continuación permiten identificar las posibles causas.
¿El retraso se limita a una habitación o a un servidor doméstico?
Compara una conexión lenta con una conexión a una sala federada diferente. Pregunta a otros usuarios de tu servidor principal si experimentan la misma demora y anota el ID o alias de la sala y los nombres de los servidores remotos involucrados. Si solo una sala es lenta, el cuello de botella podría estar en su estado o en los servidores principales que ya la componen. Si varias salas que involucran al mismo servidor remoto son lentas, verifica la accesibilidad y el estado de reintento de ese destino. Si las conexiones a muchos servidores no relacionados son lentas, investiga tus propios recursos y la ruta de federación de salida.
Para el servidor remoto afectado, consulte la API de administración de federación de Synapse desde la máquina donde se ejecuta Synapse:
curl -H "Authorization: Bearer $SYNAPSE_ADMIN_TOKEN" \
  "http://127.0.0.1:8008/_synapse/admin/v1/federation/destinations/remote.example"
Reemplace remote.examplecon el nombre del servidor principal y use la dirección del cliente-oyente para su implementación. Un valor distinto de cero retry_last_tsy positivo retry_intervalindica que Synapse ha registrado una conexión fallida reciente y está esperando antes de reintentar. Consulte los registros de Synapse correspondientes para ver el fallo real, como errores de DNS, TLS, conexión o respuesta remota. Synapse documenta esta API de administración de federación como experimental y sujeta a cambios; consulte la documentación de la versión que esté utilizando. Mantenga la API de administración privada y no copie su token de acceso en una solicitud de soporte pública.
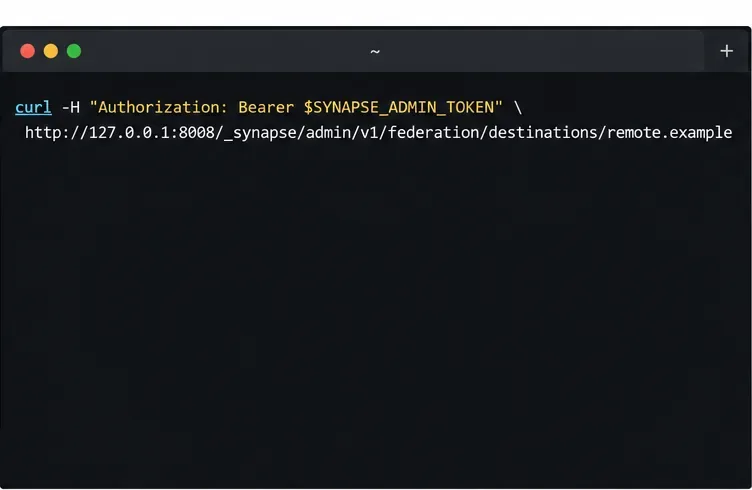
Ilustración de una solicitud de estado de destino local y autenticada. El panel muestra solo un comando, no una respuesta en tiempo real.
Si sospecha que otros servidores no pueden acceder a su servidor principal, ejecute el comprobador oficial de federación Matrix para el nombre de su servidor. Este comprueba la detección y la conectividad de la federación pública. No garantiza por sí solo que una solicitud saliente desde su host Synapse a un nodo específico se haya realizado correctamente, por lo que debe comparar su informe con sus propios registros y el estado del destino.
¿Synapse muestra un retraso creciente en la federación?
Si Prometheus ya recopila las métricas de su punto final de Synapse, agregue los dominios afectados a federation_metrics_domains, homeserver.yamlluego recargue o reinicie Synapse según su proceso de implementación. Synapse puede exponer las métricas de Prometheus para la antigüedad de los eventos de sala persistentes (PDU) enviados a y recibidos de los dominios que usted enumere, como se describe en el manual de configuración :
federation_metrics_domains:
  - matrix.org
  - remote.example
Utilice la serie temporal resultante para determinar si la antigüedad de los eventos entrantes o salientes está aumentando. Tómelo como una pista orientativa, no como un veredicto definitivo: la documentación de configuración de Synapse advierte que el retraso puede provenir tanto del servidor principal como de la red entre ellos. Una serie saliente con retraso en varios destinos apunta a la ruta de envío o a la capacidad local; si el retraso se limita a un solo par, es necesario verificar dicho par y la ruta hacia él.
Ilustración de un concepto de gráfico de la era de la federación; las líneas no son mediciones en tiempo real de un servidor Synapse.

Ilustración de la configuración de Synapse utilizada para habilitar las métricas de antigüedad de PDU para dominios remotos seleccionados.
Si muchas operaciones son lentas, compruebe también la CPU, la memoria, la latencia de la base de datos y el panel de control de duración de transacciones de Synapse. La guía de Grafana de Synapse indica que persist_eventslas escrituras de eventos en la base de datos pueden tener una duración de transacción elevada; además, explica que muchos extremos hacia adelante pueden aumentar el trabajo de resolución de estado. Si estas mediciones locales aumentan al mismo tiempo que las uniones, aborde el cuello de botella de recursos o de la base de datos antes de ajustar los reintentos de federación.
¿Ayudaría contar con más trabajadores que envíen correos electrónicos a la federación?
Agregue capacidad de envío solo cuando la monitorización muestre que el trabajo saliente está acumulado en múltiples destinos y el proceso actual está limitado. La documentación actual del trabajador de Synapse recomienda usar synapse.app.generic_workeresta federation_sender_instancesopción para esta función en lugar de crear nuevas implementaciones en torno al tipo de trabajador de envío dedicado anterior.
Cada destino de salida se asigna a un remitente en función de un hash del nombre del servidor remoto. Varios nodos de trabajo remitentes pueden distribuir el tráfico entre varios servidores remotos, pero las solicitudes a un destino lento siguen asignándose a un único nodo de trabajo. Por lo tanto, es improbable que añadir nodos de trabajo solucione un problema de un solo par. Los nombres de los nodos de trabajo en la configuración compartida deben coincidir con los nodos de trabajo en ejecución; al modificar la lista de instancias de remitente, detenga e inicie todos los remitentes de la federación simultáneamente para que utilicen la misma configuración.
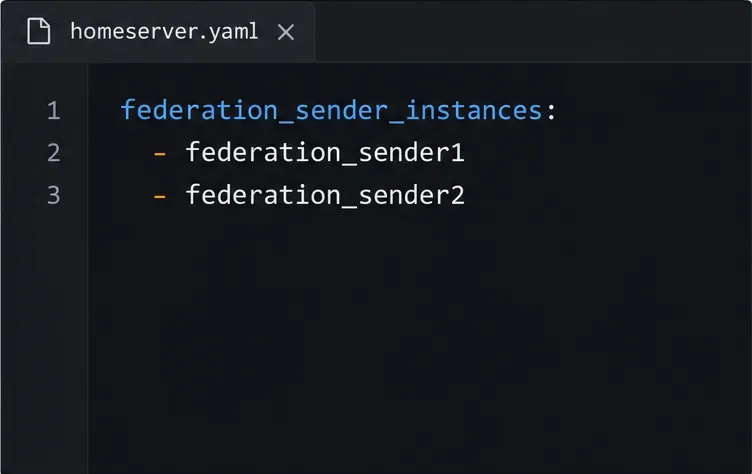
Ilustración de la lista federation_sender_instances; cada trabajador con nombre debe existir en el despliegue.
¿Deberías restablecer el backoff o aumentar el tiempo de espera?
Reinicia el temporizador de reintento de un destino solo después de corregir un problema de conectividad transitorio y confirmar que Synapse ha marcado ese destino como fallido. La API de administración proporciona un POST /_synapse/admin/v1/federation/destinations/<destination>/reset_connectionpunto final; su solicitud se ejecuta en segundo plano, por lo que una respuesta HTTP 200 inmediata no significa que la federación se haya recuperado. Este punto final también está documentado como experimental.
No lo actives federation.client_timeoutcomo primera respuesta. El manual de configuración actual establece un valor predeterminado de 60 segundos. Un tiempo de espera mayor le da a un servidor remoto lento más tiempo para responder; no acelera el servidor ni la red y puede hacer que las solicitudes de unión esperen más tiempo. Cámbialo solo cuando los registros muestren que las solicitudes de federación legítimas superan el valor actual y hayas comprobado la capacidad del servidor.
¿Cómo sabes que la solución funcionó?
Vuelva a intentar unirse a la misma sala y compárela con otra sala federada. Confirme que el destino afectado ya no muestra un intervalo de reintento creciente, que los registros muestran solicitudes de federación exitosas y que las métricas de PDU-age configuradas dejan de aumentar. Si solo una sala permanece lenta mientras que los demás destinos funcionan correctamente, comparta su ID, el servidor remoto involucrado, el intervalo de tiempo y las líneas de error censuradas con los administradores de la sala o el soporte de Synapse. Evite enviar tokens de acceso o encabezados de autorización completos.


