Inicio
» Tecnología
»
¿Qué causa las interrupciones generalizadas en las plataformas en la nube? Los patrones de fallos detrás de las principales interrupciones.
¿Qué causa las interrupciones generalizadas en las plataformas en la nube? Los patrones de fallos detrás de las principales interrupciones.
Las interrupciones generalizadas en las plataformas en la nube rara vez se deben a que un solo servidor simplemente "se caiga". Los incidentes más perjudiciales suelen comenzar con una falla técnica (una mala configuración, un defecto de software, un problema de DNS, una falla de red o un evento de infraestructura) y luego se propagan porque muchos servicios dependen de los mismos planos de control, bases de datos, sistemas de identidad, balanceadores de carga o recursos regionales.
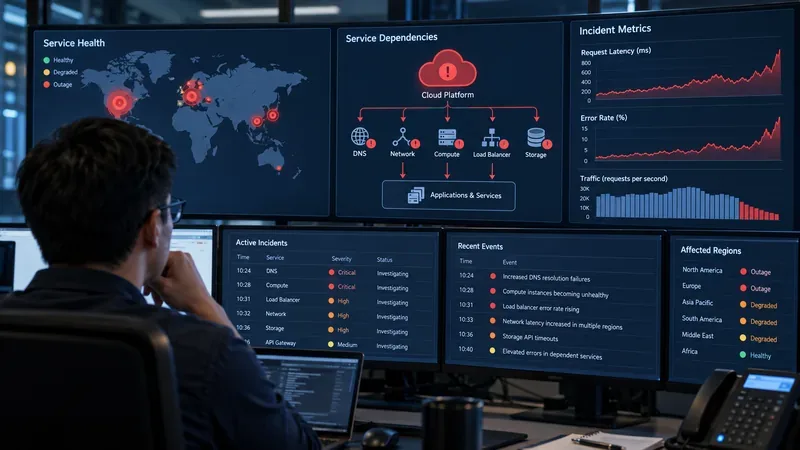
Escenario ilustrativo: imaginemos un proveedor de servicios en la nube ficticio llamado Northstar Cloud. A las 10:05, se aplica un cambio de red automatizado a un servicio regional. En cuestión de minutos, los clientes comienzan a reportar fallos en las llamadas a la API. A las 10:12, las nuevas máquinas virtuales dejan de iniciarse. A las 10:20, los balanceadores de carga comienzan a marcar los backends que funcionan correctamente como no disponibles. A las 10:35, docenas de productos aparentemente no relacionados se encuentran degradados. Este escenario es hipotético, no describe una interrupción real. Resulta útil porque muestra por qué un pequeño fallo inicial puede convertirse en un evento importante en la plataforma.
Los equipos de operaciones en la nube a menudo necesitan rastrear una interrupción desde la primera dependencia que falla, pasando por el DNS, la red, la computación, el equilibrio de carga, el almacenamiento y las aplicaciones posteriores.
En resumen: las principales interrupciones en la nube suelen ser fallos en cascada.
Las principales causas de las interrupciones generalizadas en las plataformas en la nube son los errores de configuración e implementación, los defectos de software latentes, los fallos de DNS y enrutamiento, las dependencias de servicios compartidos, el agotamiento de la capacidad durante la falla o la recuperación, los problemas del plano de control y las fallas físicas que afectan a un centro de datos o zona de disponibilidad. La magnitud de la interrupción depende menos del primer error que de la amplitud con la que se comparte el componente afectado.
Un ejemplo práctico útil proviene de AWS. En su informe oficial posterior al incidente ocurrido en octubre de 2025 en el norte de Virginia, AWS indicó que una condición de carrera latente en el sistema automatizado de administración de DNS de DynamoDB generó un registro DNS vacío incorrecto para el punto final regional. Este fallo de DNS afectó a clientes y servicios internos de AWS que dependían de DynamoDB, y las labores de recuperación posteriores contribuyeron a problemas relacionados con los lanzamientos de EC2 y los balanceadores de carga de red. El incidente está documentado en el informe de AWS posterior al incidente de DynamoDB de octubre de 2025 .
1. Los cambios de configuración pueden generar un radio de explosión inesperadamente grande.
Los errores de configuración son uno de los patrones más comunes en incidentes de sistemas distribuidos a gran escala, ya que las plataformas modernas se controlan mediante automatización. Un solo cambio puede implementarse en miles de hosts, enrutadores, registros DNS o puntos finales de servicio más rápido de lo que un operador humano podría hacerlo manualmente.
Volvamos al escenario de Northstar Cloud. Supongamos que el cambio de red de las 10:05 estaba destinado a diez máquinas, pero se aplicó a varias regiones. El cambio no tiene por qué dañar el hardware. Simplemente puede reducir la capacidad de red utilizable, alterar el enrutamiento o provocar que los sistemas rechacen tráfico que, de otro modo, sería válido. Una vez que la capacidad compartida cae por debajo de la demanda, los clientes experimentan tiempos de espera y reintentos, lo que genera aún más carga.
Google describió un mecanismo similar en su informe oficial sobre una interrupción ocurrida en 2019: un cambio de configuración destinado a un pequeño número de servidores en una región se aplicó incorrectamente de forma mucho más generalizada, lo que provocó que varias regiones dejaran de utilizar más de la mitad de su capacidad de red disponible. El tráfico congestionó entonces la capacidad restante. Consulte la actualización oficial de Google sobre la interrupción del servicio de 2019 .
Por eso, los operadores de nube experimentados utilizan implementaciones por fases, validación, reversión automatizada, límites de frecuencia de cambios y controles de "radio de impacto". Estas medidas de seguridad no eliminan los incidentes, pero pueden evitar que un cambio erróneo se convierta en un evento que afecte a toda la plataforma.
2. Los defectos de software pueden permanecer ocultos hasta que se produzcan condiciones de tiempo excepcionales.
Las grandes plataformas en la nube gestionan enormes flotas de software distribuido. Algunos defectos permanecen latentes durante meses o años porque requieren una secuencia de eventos poco común: dos controladores actualizando el mismo estado, un retraso inusual, metadatos obsoletos o un proceso de recuperación ejecutándose simultáneamente con un proceso de limpieza.
En el caso ficticio de Northstar, imaginemos que dos trabajadores automatizados independientes actualizan el mismo plan DNS. Uno se retrasa, el otro completa una actualización más reciente y, posteriormente, una rutina de limpieza elimina los datos que el trabajador retrasado acaba de activar. Cada componente individual puede parecer que funciona según lo previsto, pero su interacción genera un estado inválido.
El incidente de AWS DynamoDB de 2025 ilustra claramente esta situación. AWS atribuyó el fallo inicial a una condición de carrera latente entre componentes redundantes de gestión de DNS. Su importancia va más allá de un solo proveedor: la redundancia solo mejora la fiabilidad cuando los componentes redundantes no pueden corromper el estado compartido mediante la misma lógica o un fallo de sincronización.
3. Los fallos de DNS y de red pueden hacer que los sistemas que funcionan correctamente sean inaccesibles.
Un servicio puede estar completamente operativo y aun así no estar disponible si los clientes no pueden resolver su nombre de host o si los paquetes no pueden llegar a él. Por lo tanto, el DNS, el enrutamiento, el equilibrio de carga y la configuración de red constituyen elementos críticos para casi todos los productos en la nube.
En nuestro ejemplo de Northstar, los clientes podrían suponer que el servicio de computación ha fallado porque las llamadas a la API han expirado. Sin embargo, los servidores de computación reales podrían estar en buen estado, aunque el DNS no devuelva ningún punto final utilizable, falte una ruta o un balanceador de carga haya eliminado destinos que funcionan correctamente.
AWS ha documentado este modo de fallo en más de una ocasión. En un incidente ocurrido en la región de Seúl en 2018, AWS indicó que una actualización de configuración eliminó incorrectamente un ajuste que especificaba el número mínimo de hosts en buen estado para el conjunto de servidores DNS de EC2. La reducción de la capacidad de resolución provocó que las consultas DNS de las instancias EC2 fallaran. Los detalles se encuentran en el resumen de AWS sobre el problema de resolución DNS de EC2 de 2018 en Seúl .
Los fallos de red también se amplifican rápidamente porque las aplicaciones intentan reconectar tras un fallo. Un comportamiento de reintento agresivo puede convertir una interrupción parcial de la red en un aumento considerable del tráfico.
4. Las dependencias compartidas hacen que servicios no relacionados fallen simultáneamente.
Los servicios en la nube no son productos aislados. Una base de datos administrada puede depender de servicios de identidad, DNS interno, almacenamiento, redes, sistemas de planificación, servicios de certificados y telemetría. Una plataforma sin servidor puede depender de capacidad de procesamiento, redes, sistemas de colas y bases de datos del plano de control. Si falla una dependencia compartida, muchos productos pueden degradarse simultáneamente.
Esto explica uno de los síntomas de interrupción más confusos: los clientes ven errores en varios servicios y asumen que se produjeron varias fallas independientes. En realidad, todas las fallas visibles pueden tener la misma causa subyacente.
En el escenario de Northstar, los servicios de máquinas virtuales, contenedores y computación sin servidor podrían empezar a fallar porque dependen de la misma base de datos de recursos interna. Los productos orientados al cliente son diferentes; la dependencia subyacente no lo es.
El incidente de AWS de octubre de 2025 demostró este tipo de efecto en cascada cuando los servicios internos que dependían de DynamoDB se vieron afectados por el problema original de DNS, seguido de efectos de recuperación posteriores en EC2, Network Load Balancer, Lambda, servicios de contenedores, funciones relacionadas con la identidad y otros productos.
5. La recuperación puede fallar porque la acumulación de tareas pendientes es mayor que la carga operativa normal.
Restaurar el componente defectuoso original no siempre soluciona una interrupción del servicio. Durante el tiempo de inactividad, las colas crecen, los contratos de arrendamiento expiran, las comprobaciones de estado fallan, los escaladores automáticos solicitan capacidad de reemplazo, los clientes reintentan las solicitudes y se acumulan las actualizaciones de configuración. Cuando la dependencia que falló se restablece, todos los sistemas en espera pueden intentar recuperarse simultáneamente.
En el ejemplo de Northstar, supongamos que el DNS se repara a las 10:45. Miles de hosts de computación intentan renovar las concesiones vencidas. Al mismo tiempo, los clientes vuelven a intentar las implementaciones fallidas y los sistemas de autoescalado solicitan instancias de reemplazo. El plano de control procesa repentinamente varias veces su carga de trabajo normal. Si no cuenta con límites de velocidad efectivos ni priorización de recuperación, puede entrar en un segundo modo de fallo, incluso aunque el error original haya desaparecido.
AWS describió un problema de recuperación similar en 2025: tras restablecerse el acceso a DynamoDB, un subsistema EC2 tuvo que volver a generar un gran número de concesiones. El procesamiento de la cola de espera se complicó antes de que se produjeran los tiempos de espera, y AWS indicó que el subsistema entró en un estado de "colapso por congestión". Este detalle es importante porque explica por qué la duración de una interrupción puede ser mucho mayor que el tiempo necesario para solucionar el problema inicial.
6. Las comprobaciones de estado y la conmutación por error automatizada a veces pueden eliminar una buena capacidad.
Las comprobaciones de estado son esenciales, pero también implican la toma de decisiones automatizadas. Si una red es lenta o la propagación del estado se retrasa, un sistema de comprobación de estado puede concluir que los recursos que funcionan correctamente están defectuosos y desconectarlos. Esto puede reducir aún más la capacidad, generando un círculo vicioso.
En el escenario ficticio, los balanceadores de carga de Northstar comienzan a comprobar las instancias recién lanzadas antes de que la configuración de red se haya propagado por completo. Las comprobaciones fallan, las instancias en buen estado se retiran, el tráfico se desvía hacia los nodos restantes, que se sobrecargan.
Este patrón también se observó durante el evento de AWS de 2025. AWS indicó que las comprobaciones de estado del Network Load Balancer a veces fallaban mientras el estado de la red para las nuevas instancias aún se estaba propagando, lo que provocaba la retirada de capacidad del servicio. Esto nos recuerda que la lógica de conmutación por error debe limitarse y probarse en caso de fallo parcial, no solo en condiciones de funcionamiento óptimo o ineficiente.
7. Siguen siendo posibles los fallos en los centros de datos, la alimentación eléctrica, la refrigeración y las zonas de disponibilidad.
No todas las interrupciones se originan en el software. La alimentación eléctrica, la refrigeración, la fibra óptica, el hardware de red y otras infraestructuras físicas pueden fallar. La arquitectura en la nube se diseña teniendo en cuenta esta realidad, por lo que los principales proveedores dividen las regiones en zonas aisladas de fallos.
Microsoft explica que las Zonas de Disponibilidad de Azure son grupos separados de centros de datos con alimentación, refrigeración y redes independientes. Microsoft también señala que una implementación zonal no sobrevive automáticamente a una interrupción de zona; los clientes deben usar varias zonas o servicios con redundancia de zona cuando sea compatible. Consulte la descripción general oficial de las Zonas de Disponibilidad de Azure de Microsoft .
En términos prácticos, un proveedor de servicios en la nube puede hacer que una zona sea independiente, pero la carga de trabajo de un cliente aún puede tener una base de datos de una sola zona, una dependencia de control regional única o un proceso de conmutación por error que nunca se haya puesto en práctica.
Por qué una interrupción en la nube puede parecer global incluso cuando la causa principal es regional.
El término «interrupción global» suele describir el impacto en los clientes, no la ubicación física del equipo averiado. Un servicio regional puede dar soporte a la autenticación, DNS, metadatos, flujos de trabajo, paneles de control o API de control utilizadas desde otras regiones. Por lo tanto, las aplicaciones de todo el mundo pueden fallar porque dependen de un servicio concentrado en una sola ubicación.
Esta distinción es crucial al diagnosticar un incidente. Los ingenieros deben plantearse dos preguntas distintas: ¿ Dónde se produjo el primer fallo? y ¿Qué dependencias permitieron que ese fallo se propagara? Las respuestas suelen ser diferentes.
Cómo identificar la causa probable durante un incidente en directo.
Para los operadores, la vía más rápida suele ser correlacionar los síntomas en lugar de investigar cada producto por separado. Si varios servicios fallan al mismo tiempo, busque una dependencia común. Si las cargas de trabajo existentes se mantienen estables mientras que las nuevas implementaciones fallan, sospeche de un problema en el plano de control, la programación, la capacidad o el aprovisionamiento. Si la conectividad IP funciona pero los nombres de servicio fallan, investigue el DNS. Si las tasas de error aumentan después de un anuncio de recuperación, busque tormentas de reintentos, retrasos, concesiones caducadas, bucles de retroalimentación de comprobación de estado o capacidad de recuperación insuficiente.
Los sistemas de estado del proveedor también pueden ayudar a distinguir un incidente de plataforma de una falla específica de la aplicación. Google Cloud, por ejemplo, publica incidentes actuales e históricos a través de su panel oficial de Service Health , mientras que AWS publica resúmenes de eventos importantes a través de sus resúmenes posteriores a eventos oficiales .
Qué pueden hacer los clientes para reducir el impacto
Ninguna arquitectura puede garantizar cero tiempo de inactividad, pero varias decisiones de diseño reducen la exposición. Utilice múltiples zonas de disponibilidad para cargas de trabajo de producción cuando el servicio lo permita. Para cargas de trabajo que no toleran una interrupción regional, evalúe diseños multirregionales y comprenda las ventajas y desventajas en cuanto a la coherencia de los datos. Elimine los puntos únicos de fallo ocultos, como un único servicio de identidad regional, una única ruta DNS o una única API administrativa de la que dependa toda acción de recuperación.
Las aplicaciones también deben gestionar los fallos de forma controlada. Esto puede implicar servir contenido en caché, poner en cola las escrituras no críticas, limitar los reintentos con retroceso exponencial y fluctuación, separar las operaciones del plano de control del tráfico del plano de datos y mantener un modo reducido de "solo lectura" o "transacción principal" durante las interrupciones parciales. Los procedimientos de recuperación deben probarse en condiciones de cola de espera, ya que reiniciar una dependencia en un entorno de prueba vacío es muy diferente a restaurarla mientras millones de solicitudes están en espera.
La lección clave de las interrupciones generalizadas en la nube
Volvamos al escenario de Northstar Cloud. El cambio de configuración de las 10:05 puede ser el detonante, pero no es la explicación completa. La interrupción se generaliza porque la red es compartida, la automatización presenta un fallo de sincronización, los servicios posteriores dependen del mismo estado, las comprobaciones de estado reducen la capacidad, los reintentos aumentan la carga y los sistemas de recuperación deben procesar una enorme cantidad de tareas pendientes.
Ese es el patrón central detrás de muchos incidentes importantes en la nube: el fallo inicial suele ser pequeño en comparación con la cadena de dependencias que lo amplifica. Por lo tanto, comprender el tiempo de inactividad en la nube implica examinar tanto la causa raíz como su propagación. Los diseños más resilientes parten de la base de que los componentes individuales fallarán y se centran en evitar que esos fallos se conviertan en eventos que afecten a todo el sistema.