Inicio
» Tecnología
»
Semiconductores de próxima generación: cómo la IA y la supercomputación están yendo más allá de los transistores más pequeños.
Semiconductores de próxima generación: cómo la IA y la supercomputación están yendo más allá de los transistores más pequeños.
La respuesta corta: las ventajas de la IA ahora provienen de todo el sistema de semiconductores.
La próxima generación de hardware de IA y supercomputación no se basa en un único avance tecnológico, sino en diversas tecnologías que deben trabajar conjuntamente: transistores con puerta envolvente, alimentación por la parte posterior, arquitecturas de chiplets, encapsulado avanzado, memoria de alto ancho de banda, enlaces entre chips más rápidos y, cada vez más, redes ópticas. El resultado práctico es mayor capacidad de procesamiento, mayor ancho de banda de memoria y mejor escalabilidad, sin depender únicamente de transistores más pequeños.
Esto es importante porque los aceleradores de IA modernos y las supercomputadoras científicas suelen alcanzar límites de transferencia de datos y consumo de energía antes de agotar su capacidad aritmética. Un motor de matrices más rápido solo resulta útil si los pesos del modelo, las activaciones y los resultados intermedios pueden llegar a él con la suficiente rapidez. Del mismo modo, añadir más aceleradores solo es útil si el paquete, la red de racks, el sistema de memoria, el sistema de refrigeración y el conjunto de software pueden mantenerlos ocupados.
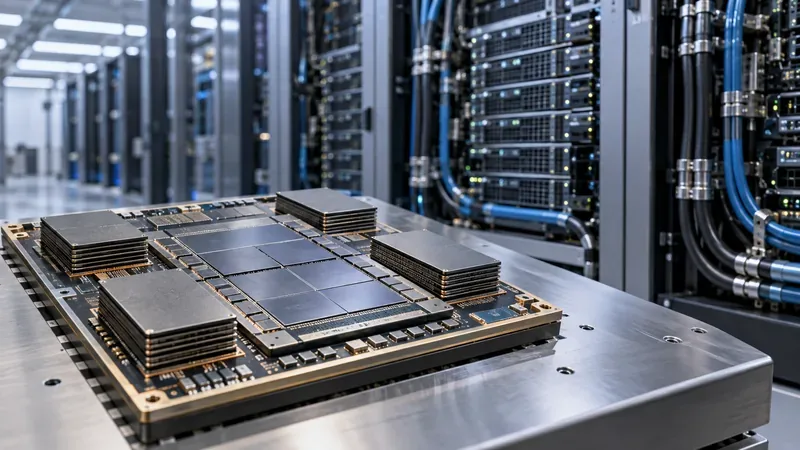
Un módulo acelerador multichip con varios paquetes de memoria apilados ilustra la dirección que está tomando el hardware de IA moderno: el procesamiento, la memoria, el empaquetado, el suministro de energía y la refrigeración se diseñan cada vez más como un único sistema.
1. Las nuevas estructuras de transistores mejoran la eficiencia, pero son solo el punto de partida.
La lógica de vanguardia está superando la estructura FinFET que dominó los chips avanzados durante años. Los diseños de compuerta envolvente (GAA) envuelven la compuerta alrededor de una nanohoja o una estructura de canal similar, lo que permite a los diseñadores de chips un control electrostático más preciso a medida que se reducen las características. Esto puede mejorar el rendimiento, reducir las fugas o proporcionar un mejor equilibrio entre ambos.
TSMC afirma que su proceso N2 de 2 nanómetros entró en producción en serie en el cuarto trimestre de 2025, mientras que su tecnología A16 combina transistores de nanohojas con una línea de alimentación posterior, especialmente diseñada para productos de computación de alto rendimiento con altas necesidades de suministro de energía. TSMC ha indicado que la producción en serie de A16 está programada para la segunda mitad de 2026. Consulte la página de la tecnología A16 de la fundición y el informe anual de 2025 .
Intel sigue una dirección similar con Intel 18A. Su proceso combina transistores RibbonFET GAA con suministro de energía PowerVia en la parte posterior. Intel informa que 18A entró en producción en 2025, mientras que la versión mejorada 18A-P entró en producción de riesgo en junio de 2026. Intel también publica datos comparativos sobre rendimiento, consumo de energía y densidad para este nodo; estas cifras son proporcionadas por el fabricante y deben validarse con un diseño específico en lugar de considerarse como mejoras universales a nivel de chip. Los detalles actuales se encuentran en la página del proceso 18A de Intel .
La alimentación en la parte posterior es importante porque los chips avanzados deben enrutar tanto las señales como la energía a través de un cableado extremadamente denso. Trasladar parte de la red de suministro de energía a la parte posterior puede liberar recursos de enrutamiento en el lado de la señal y mejorar el suministro de voltaje. Para los aceleradores de IA, donde grandes conjuntos de unidades de cómputo conmutan a altas velocidades, esto puede ser tan importante como la densidad de transistores.
2. Los chiplets y el empaquetado avanzado están convirtiendo un paquete en un pequeño sistema informático.
Los chips monolíticos se vuelven más difíciles y costosos de escalar a medida que crecen. Los chiplets ofrecen una alternativa: las funciones independientes se pueden fabricar con tecnologías de proceso que se ajusten mejor a ellas y luego se conectan dentro de un mismo paquete. Un chip de procesamiento puede requerir el proceso lógico más avanzado, mientras que las funciones de E/S, caché, circuitos analógicos u otras funciones no necesariamente.
El empaquetado es lo que hace que esto sea práctico. La plataforma de empaquetado avanzado CoWoS de TSMC , por ejemplo, está diseñada para integrar múltiples dispositivos lógicos y pilas de memoria de alto ancho de banda en un paquete 2.5D. TSMC posiciona específicamente CoWoS para productos de IA y HPC, donde las conexiones cortas y anchas entre la computación y la HBM son fundamentales.
También están surgiendo estándares para reducir la dependencia de los chiplets con respecto a los sistemas propietarios. La especificación UCIe 3.0 , publicada en agosto de 2025, admite velocidades de datos de 48 GT/s y 64 GT/s, e incorpora funciones para mejorar la eficiencia energética, la gestión y la flexibilidad de los sistemas multichip. Si bien UCIe no permite la intercambiabilidad inmediata de los chiplets, proporciona a la industria un marco eléctrico y de protocolo común para los enlaces integrados en el encapsulado.
Este enfoque resulta especialmente atractivo cuando una empresa desea construir varias variantes de aceleradores a partir de bloques de construcción reutilizables. Es menos atractivo cuando el costo del encapsulado, la densidad térmica o la complejidad del diseño superan la ventaja de la modularidad. Un producto más pequeño con necesidades modestas de memoria y E/S podría beneficiarse más de un dispositivo monolítico más sencillo.
3. La memoria de alto ancho de banda se está volviendo tan estratégica como el propio acelerador.
Las cargas de trabajo de IA transfieren repetidamente grandes tensores entre la memoria y las unidades de procesamiento. Esto convierte el ancho de banda de la memoria en una restricción de diseño fundamental. La memoria de alto ancho de banda (HBM) soluciona este problema apilando chips DRAM y colocándolos físicamente cerca del acelerador mediante una interfaz muy amplia.
La memoria HBM4 está pasando de ser una hoja de ruta a un sistema comercial. Samsung anunció el inicio de los envíos comerciales de HBM4 en febrero de 2026 e indicó que su producto entró en producción en masa con una velocidad de transferencia sostenida de 11,7 Gb/s, con capacidad para alcanzar hasta 13 Gb/s. En mayo de 2026, Samsung también anunció el envío de muestras de HBM4E. Estos detalles están disponibles en el anuncio de producción de HBM4 de Samsung .
SK hynix anunció en sus resultados del segundo trimestre de 2026 que inició envíos masivos de HBM4 durante dicho trimestre y que planea aumentar la producción en la segunda mitad del año. La compañía también ha enviado muestras de HBM4E de 12 capas. Consulte los resultados del segundo trimestre de 2026 de SK hynix para conocer la situación actual.
¿Por qué es importante esto en la práctica? Las especificaciones actuales de NVIDIA Vera Rubin indican 288 GB de HBM4 en una GPU Rubin y un ancho de banda de memoria de GPU de 19,2 TB/s. En comparación, los aceleradores de la serie MI350 de AMD utilizan HBM3E; AMD indica hasta 288 GB y 8 TB/s para el MI355X. Se trata de arquitecturas diferentes y no deben compararse basándose únicamente en una cifra de ancho de banda, pero ambas ilustran cómo la capacidad de memoria y el ancho de banda son ahora especificaciones centrales del acelerador, en lugar de detalles secundarios. Consulte las especificaciones oficiales de NVIDIA Vera Rubin NVL72 y la página de AMD Instinct MI350 Series .
4. Las interconexiones de escalado vertical y horizontal determinan si muchos aceleradores actúan como uno solo.
Los modelos complejos y las simulaciones científicas rara vez caben perfectamente en un solo dispositivo. El sistema debe distribuir el trabajo entre varios aceleradores e intercambiar resultados parciales con frecuencia. Si la comunicación es lenta, las costosas unidades de cálculo permanecen inactivas.
Por eso, las arquitecturas de escalado propietario están evolucionando a la par que las propias GPU. La plataforma Rubin de NVIDIA utiliza NVLink de sexta generación; NVIDIA indica un ancho de banda de NVLink de 3 TB/s por GPU Rubin y de 216 TB/s en un sistema NVL72. AMD utiliza Infinity Fabric en todas sus plataformas aceleradoras. Para los compradores, la cuestión importante no es solo el ancho de banda máximo del enlace, sino cómo se comporta la arquitectura bajo las operaciones colectivas, los patrones de paralelismo de modelos y la topología específicos que utiliza la aplicación.
A nivel de memoria del sistema, Compute Express Link también está evolucionando. El Consorcio CXL afirma que CXL 4.0 duplica la velocidad de señalización de 64 GT/s a 128 GT/s, añade puertos integrados y amplía las funciones de fiabilidad de la memoria. CXL resulta relevante cuando los arquitectos buscan una expansión, agrupación o desagregación coherente de la memoria sin tratar cada nivel de memoria como un dispositivo de almacenamiento remoto.
5. La fotónica de silicio se está acercando al silicio de conmutación.
El cobre sigue siendo excelente para conexiones eléctricas cortas y densas, pero los enlaces ópticos resultan cada vez más atractivos a medida que aumenta la distancia y el ancho de banda total. Un paso importante a seguir es la integración de componentes ópticos, donde estos se ubican más cerca del ASIC de red en lugar de residir completamente en transceptores conectables en el extremo de un conmutador.
NVIDIA afirma que su plataforma de fotónica Ethernet Spectrum-X utiliza óptica integrada y ofrece una eficiencia energética de red hasta cinco veces superior a la de los diseños tradicionales con transceptores conectables. Si bien se trata de una comparación entre proveedores, no una garantía para todas las topologías de centros de datos, pone de manifiesto la tendencia actual: la eficiencia energética de la red está adquiriendo tal relevancia que la integración óptica forma parte del diseño de sistemas semiconductores. Consulte la descripción general de la fotónica de silicio de NVIDIA .
¿Qué significa esto para las cargas de trabajo reales de IA y supercomputación?
Carga de trabajo
Características de los semiconductores a priorizar
Por qué son importantes
Preentrenamiento de modelos grandes
Capacidad y ancho de banda de HBM, enlaces de escalado rápido, empaquetado denso, refrigeración potente
El entrenamiento requiere una gran inversión en el movimiento tensorial y la comunicación sincronizada entre múltiples aceleradores.
Inferencia de contexto largo y de agencia
Grandes grupos de memoria HBM, computación eficiente de baja precisión, alto ancho de banda de interconexión, estratificación de memoria.
La caché KV y los pasos de razonamiento repetidos pueden hacer que la capacidad de memoria y el movimiento de datos sean factores más limitantes que el pico de FLOPS.
Computación de alto rendimiento científica
Capacidad FP64, ancho de banda de memoria, interconexiones fiables, bibliotecas numéricas consolidadas.
Los códigos de simulación suelen depender de la doble precisión y del ancho de banda sostenido, en lugar de depender únicamente del rendimiento de tensores de baja precisión.
Inferencia empresarial
Rendimiento por vatio, compatibilidad de software, memoria del tamaño adecuado, opciones de implementación PCIe.
El mejor sistema podría ser aquel que se adapte a los servidores y a los límites de potencia existentes, en lugar de la arquitectura de rack de mayor densidad.
Aceleradores personalizados
Estrategia de chiplets, ecosistema de empaquetado, soporte de UCIe, madurez del proceso
La modularidad puede acortar los ciclos de reutilización, pero la complejidad del embalaje y la cualificación de la cadena de suministro pueden contrarrestar este beneficio.
Un ejemplo concreto: por qué una GPU más rápida no es suficiente
Consideremos un equipo que gestiona un modelo de lenguaje extenso con ventanas de contexto amplias. Supongamos que el análisis de rendimiento muestra que las GPU suelen estar en espera de transferencias de memoria y comunicación entre ellas. Cambiar a un acelerador más moderno podría ser útil, pero solo si el nuevo sistema también ofrece suficiente capacidad HBM, mayor ancho de banda de memoria y una topología que reduzca las interrupciones en la comunicación. Adquirir un dispositivo con un rendimiento tensorial teórico superior, manteniendo los mismos cuellos de botella de memoria y red, podría ofrecer una mejora mucho menor de la que sugieren las especificaciones principales.
El mismo principio se aplica a la supercomputación tradicional. El sistema Frontier del Laboratorio Nacional de Oak Ridge combina aceleradores AMD MI250X con HBM y una interconexión de sistema de alta velocidad. La guía del usuario de Frontier documenta cómo funcionan conjuntamente la computación, la HBM, los enlaces CPU-GPU y la red Slingshot. Si bien la generación de hardware es anterior a las plataformas de IA más recientes de 2026, la lección arquitectónica sigue vigente: el rendimiento sostenido de las aplicaciones depende de la ruta entre la computación, la memoria y otros nodos.
¿Cuándo merece la pena actualizar al hardware de semiconductores de próxima generación?
Una actualización es más justificable cuando resuelve un cuello de botella comprobado, en lugar de simplemente reemplazar una pieza antigua. Antes de optar por una nueva generación de aceleradores, verifique lo siguiente:
Presión de memoria: ¿El modelo o la simulación se desbordan a la memoria del host, requieren puntos de control agresivos o fuerzan un grado inconveniente de partición del modelo?
Presión de ancho de banda: ¿Los kernels están limitados por la memoria al realizar el análisis de rendimiento, o los aceleradores dedican un tiempo significativo a esperar a que finalicen las operaciones de reducción total y otras operaciones colectivas?
Alimentación y refrigeración: ¿Pueden el rack, las instalaciones y el circuito de refrigeración soportar la nueva densidad de potencia? Un mayor rendimiento puede no ser viable si las mejoras de infraestructura representan un coste excesivo.
Preparación del software: ¿El compilador, las bibliotecas, los núcleos, la pila de orquestación y las herramientas de monitorización están lo suficientemente maduros para la nueva arquitectura?
Requisitos de precisión: ¿Puede la carga de trabajo utilizar formatos de menor precisión de forma segura, o requiere FP64 u otra ruta de mayor precisión?
Utilización: ¿La carga de trabajo mantendrá el nuevo hardware lo suficientemente ocupado como para justificar su coste? La capacidad que permanece inactiva no se vuelve rentable solo porque el chip sea más nuevo.
Las compensaciones se están volviendo más físicas.
El progreso en semiconductores está generando capacidades impresionantes, pero los factores limitantes son cada vez más evidentes. Los encapsulados avanzados son más grandes y difíciles de fabricar. Las pilas HBM concentran el calor cerca de la lógica de alta potencia. Los sistemas a escala de rack pueden requerir refrigeración líquida, distribución de energía densa y redes especializadas. La óptica coempaquetada puede reducir el consumo de energía de la red, pero introduce nuevas consideraciones de fabricación y mantenimiento. Los chiplets pueden mejorar la modularidad, pero añaden trabajo de validación, encapsulado y gestión del rendimiento.
También existe una contrapartida en el software. La aritmética de baja precisión, como FP8, FP6 o FP4, puede aumentar considerablemente el rendimiento de la IA, pero el software debe preservar la calidad del modelo. Los códigos científicos quizás no puedan usar los mismos atajos. Una característica de un semiconductor solo es valiosa cuando la pila de aplicaciones puede aprovecharla sin infringir los requisitos de precisión o fiabilidad.
¿Qué ver a continuación?
Para lo que queda de 2026 y para 2027, las señales más útiles no son solo los nuevos nombres de nodos. Hay que estar atentos a si los procesos A16 de TSMC y la familia 18A de Intel se incorporan a productos de consumo masivo; con qué rapidez HBM4 y HBM4E estarán disponibles a gran escala; si UCIe 3.0 crea una interoperabilidad significativa entre chiplets de diferentes proveedores; dónde aparece CXL 4.0 en los sistemas de producción; y si la óptica integrada resulta económica y funcional a gran escala.
Estos hitos demostrarán si la industria de los semiconductores puede seguir ampliando la IA y la supercomputación sin permitir que el movimiento de la memoria, el suministro de energía, las redes y la refrigeración consuman las ventajas obtenidas gracias a una lógica más densa.
En resumen
El futuro de la IA y la supercomputación depende cada vez menos de un único nodo de última generación y más de la ingeniería coordinada de semiconductores. Los transistores GAA y la alimentación por la parte posterior mejoran la base lógica. Los chiplets y el empaquetado avanzado permiten a los diseñadores ensamblar sistemas más grandes de los que un solo chip puede proporcionar cómodamente. La memoria HBM4 alimenta los aceleradores con un ancho de banda extremo. UCIe, CXL, NVLink, Infinity Fabric y las redes ópticas transfieren datos a través de dominios cada vez mayores.
Si va a elegir hardware, comience por el principal cuello de botella de su carga de trabajo. Para IA con uso intensivo de memoria, priorice la capacidad y el ancho de banda de la memoria HBM. Para el entrenamiento distribuido, priorice la escalabilidad horizontal y vertical. Para computación científica, verifique el rendimiento de FP64 y las bibliotecas. Para implementaciones empresariales, tenga en cuenta la alimentación, la refrigeración, el soporte de software y el esfuerzo de integración. El semiconductor más rápido sobre el papel no es automáticamente el sistema más rápido ni el más económico para su carga de trabajo.